


















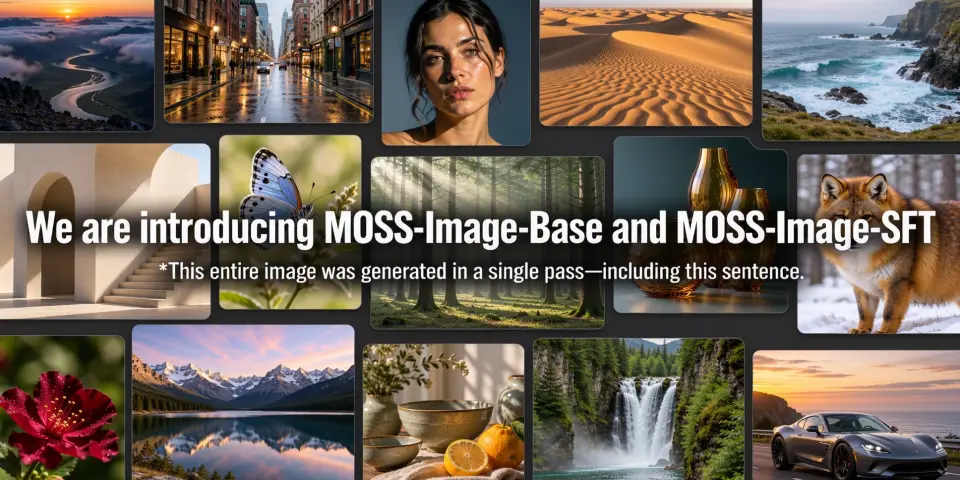
โมเดลสร้างภาพข้อความเป็นรูปภาพจาก OpenMOSS ที่รองรับคำสั่งภาษาไทยและ JSON สำหรับจัดการตำแหน่งวัตถุ
MOSS-Image-Base เป็นโมเดล text-to-image พื้นฐานจากตระกูล MOSS-Image ของ OpenMOSS ที่ช่วยให้ผู้ใช้งานสามารถสร้างรูปภาพผ่านข้อความ prompt แบบภาษาธรรมชาติ ชุดแท็ก และโครงสร้าง JSON สำหรับควบคุมการจัดวางข้อความและตำแหน่งวัตถุภายในภาพได้ตามต้องการ โมเดลนี้ถูกเผยแพร่ภายใต้ Apache License, Version 2.0 พร้อมโค้ด inference ที่บันเดิลมาให้
ในส่วนของการทำงาน โมเดลนี้ใช้สถาปัตยกรรมที่รองรับทั้ง Python API และอินเทอร์เฟซแบบ Gradio รวมถึงมีปลั๊กอินสำหรับใช้งานบน ComfyUI ผ่าน ComfyUI Manager การตั้งค่าการสุ่มตัวอย่างค่าเริ่มต้นใช้ Flow-matching Euler ที่ 50 ขั้นตอน ค่า CFG เท่ากับ 3 และ Shift เท่ากับ 5 โดยขนาดภาพที่ใช้กับ Python API จะต้องเป็นพหคูณของ 16
โปรเจกต์นี้กำลังได้รับความสนใจบน Hugging Face โดยมียอดดาวน์โหลด 2,774 ครั้ง ยอดถูกใจ 356 ครั้ง และติดอันดับที่ 12 ในหน้าโปรเจกต์ที่กำลังมาแรง นอกจากนี้ยังมีเครื่องมือเสริมอย่าง MOSS-Image Prompt Enhancer สำหรับแปลงไอเดียให้เป็นคำบรรยายละเอียดหรือ layout พร้อมใช้งาน
✨ จุดเด่น
- รองรับหลากหลายรูปแบบ — รับคำสั่งได้ทั้งภาษาธรรมชาติ ชุดแท็ก และโครงสร้าง JSON
- ควบคุมตำแหน่งได้ — รองรับ JSON layout สำหรับกำหนดตำแหน่งวัตถุและข้อความในภาพ
- ใช้งานกับเครื่องมือยอดนิยม — รองรับการใช้งานผ่าน Python API, Gradio และ ComfyUI
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาหรือผู้ใช้งานที่ต้องการโมเดลสร้างภาพควบคุมตำแหน่งได้ โดยต้องใช้ Python 3.10 ขึ้นไป และการ์ดจอ NVIDIA ที่รองรับ CUDA พร้อม PyTorch 2.9 ขึ้นไป
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ OpenMOSS-Team/MOSS-Image-Base — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...