


















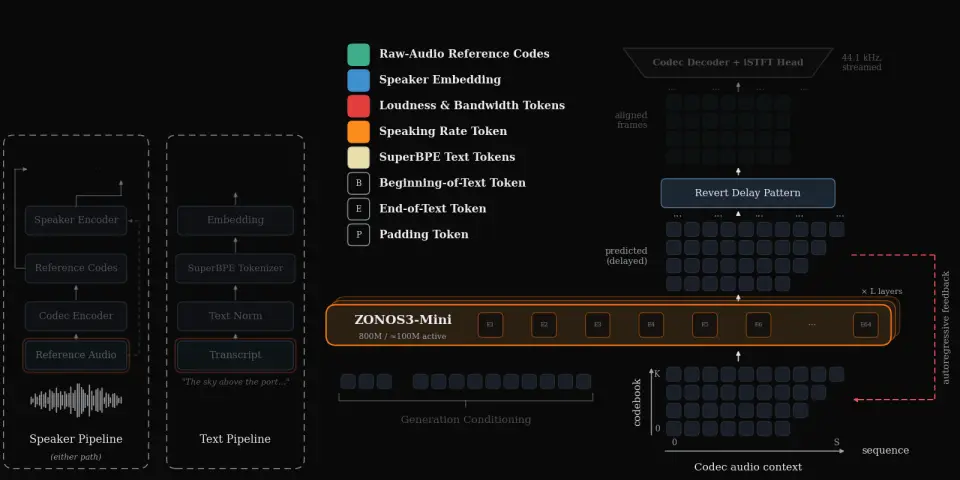
โมเดล Text-to-Speech ขนาดเล็กจาก Zyphra ที่ทำงานได้แบบเรียลไทม์ โคลนเสียงได้ และรันบนเบราว์เซอร์ได้ทันที
Zyphra ZONOS3-Mini เป็นโมเดลแปลงข้อความ เป็นเสียงพูด (Text-to-Speech) แบบโอเพนซอร์สที่มีพารามิเตอร์ทำงานอยู่ 100 ล้านตัวจากทั้งหมด 800 ล้านตัว รองรับการใช้งานรวม 43 ภาษา ซึ่งรวมถึงภาษาไทยด้วย โมเดลนี้ถูกพัฒนาขึ้นเพื่อแก้ปัญหาการสร้างเสียงพูดที่สมจริง รองรับการโคลนเสียงจากตัวอย่างเสียง และปรับแต่งบุคลิกของเสียงได้ตามต้องการ
การทำงานของโมเดลใช้สถาปัตยกรรมแบบไฮบริด GDN และ attention MoE โดยแปลงข้อความด้วย SuperBPE และสร้างเฟรมเสียงผ่านโคเดกแบบ dual-codec พร้อมตัวถอดรหัส iSTFT ที่สร้างเสียงความถี่ 44.1 kHz ได้ทันทีเมื่อประมวลผลเสร็จ ผู้ใช้สามารถรันโมเดลนี้แบบโลคัลผ่านเบราว์เซอร์ด้วย WebGPU โดยไม่ต้องติดตั้งโปรแกรม หรือใช้งานผ่าน SGLang บน GPU ของ NVIDIA รวมทั้งมีเซิร์ฟเวอร์สำหรับ Apple Silicon และ C++/ggml ด้วย
โปรเจกต์นี้ได้รับความสนใจในชุมชนนักพัฒนาบน Hugging Face โดยอยู่ในอันดับ #11 ในหน้ากำลังมาแรง ทำยอดดาวน์โหลดไปแล้ว 8,543 ครั้ง และมีผู้กดถูกใจ 248 ครั้ง โมเดลเผยแพร่ภายใต้สัญญาอนุญาต Apache 2.0 สำหรับน้ำหนักโมเดล โดยมีบล็อกโพสต์และเอกสารคู่มือพร้อมตัวอย่างการใช้งานรองรับ
สำหรับจุดเด่นของ ZONOS3-Mini คือความสามารถในการโคลนเสียงเพียงใช้คลิปเสียงตัวอย่าง ปรับแต่งอารมณ์และจังหวะการพูดได้ระดับคำ และรองรับการทำงานแบบเรียลไทม์บนโทรศัพท์และแล็ปท็อป
✨ จุดเด่น
- รองรับ 43 ภาษา — มีภาษาไทย รวมถึงภาษาหลักในยุโรป เอเชีย และตะวันออกกลาง
- รันบนเบราว์เซอร์ได้ — ทำงานผ่าน WebGPU ได้ทันทีโดยไม่ต้องติดตั้งโปรแกรมเพิ่มผ่าน Zonos Voice Studio หรือ Lite
- โคลนเสียงและปรับแต่งได้ — สร้างเสียงจากตัวอย่างเสียง พร้อมควบคุมอายุ สําเนียง อารมณ์ และความเร็วในการพูดได้
- โอเพนซอร์ส Apache 2.0 — เปิดให้นักพัฒนานำน้ำหนักโมเดลไปใช้งานต่อและปรับแต่งได้อย่างอิสระ
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาซอฟต์แวร์และผู้สนใจสร้างระบบเสียง ผู้ใช้งานต้องการเบราว์เซอร์ที่รองรับ WebGPU หรือการ์ดจอ NVIDIA หรือ Apple Silicon สำหรับการรันโมเดลในเครื่อง
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ Zyphra/ZONOS3-Mini — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...