โมเดล Mixture-of-Experts ขนาดใหญ่ รองรับรูปภาพและข้อความ พร้อมความสามารถรอบด้านทั้งการเขียนโค้ดและวิเคราะห์
Mistral Large 4 หรือที่รู้จักในชื่อ Le Chonk เป็นโมเดล Mixture-of-Experts (MoE) แบบมัลติโมเดลขนาด 1 ล้านล้านพารามิเตอร์ โดยมีพารามิเตอร์ทำงานจริง 49,000 ล้านตัวต่อโทเค็น โมเดลนี้ถูกฝึกมาจากศูนย์บนการ์ดจอ NVIDIA Grace Blackwell จำนวน 3,800 ตัว ในศูนย์ข้อมูลของ Mistral ในยุโรป
โมเดลตัวนี้ถูกออกแบบมาเพื่อรวมความสามารถในการทำตามคำสั่ง การใช้เหตุผล การเขียนโค้ด และเวิร์กโฟลว์เอเจนต์ไว้ในชุดน้ำหนักเดียว รองรับการป้อนข้อมูลทั้งข้อความและรูปภาพ พร้อมหน้าต่างบริบท (Context Window) ขนาด 1M และยังรองรับการใช้งานมากกว่า 160 ภาษา
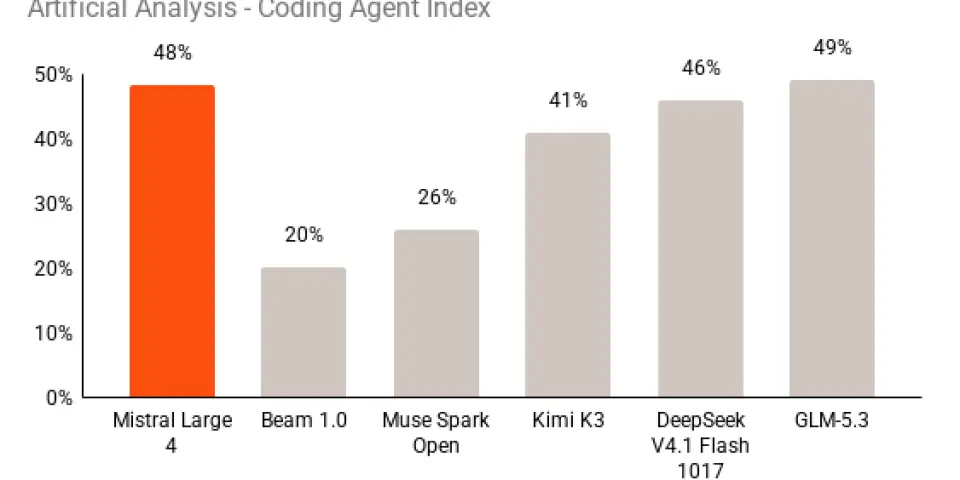
ในส่วนของประสิทธิภาพ Mistral Large 4 ทำคะแนนบน Artificial Analysis Coding Agent Index ได้ 48% และได้คะแนน Global Intelligence Index v5 อยู่ที่ 26 ซึ่งสูงที่สุดในกลุ่มโมเดล open-weight จากฝั่งตะวันตก นอกจากนี้ยังมีเวอร์ชัน NVFP4 ให้เลือกใช้งานสำหรับผู้ที่ต้องการประหยัดหน่วยความจำและเร่งความเร็วในการประมวลผลบนการ์ดจอ Blackwell
✨ จุดเด่น
- สถาปัตยกรรม — โมเดล MoE ขนาดประมาณ 1 ล้านล้านพารามิเตอร์ ทำงานจริงประมาณ 52,000 ล้านพารามิเตอร์
- รองรับบริบท — รองรับหน้าต่างบริบทความยาวถึง 1M
- ความสามารถมัลติโมเดล — รองรับอินพุตทั้งข้อความและรูปภาพ พร้อมวิเคราะห์แผนภูมิและเอกสารได้
- ภาษา — รองรับมากกว่า 160 ภาษา รวมถึงภาษาราชการของสหภาพยุโรปทั้งหมด
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาและองค์กรที่ต้องการใช้งาน AI ประสิทธิภาพสูงด้านการเขียนโค้ด การวิเคราะห์ และงานเอเจนต์ โดยสามารถปรับใช้ผ่านไลบรารีอย่าง vLLM, SGLang, transformers หรือ llama.cpp
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ mistralai/Mistral-Large-4-1T-A52B — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...