


















เครื่องมือโอเพนซอร์สสำหรับสร้างวิดีโอคนพูดที่เน้นความเป็นธรรมชาติและการขยับปากให้ตรงกับเสียง
LongCat-Video-Avatar-1.6 เป็นโมเดล AI ที่พัฒนาขึ้นเพื่อสร้างวิดีโอคนพูดโดยใช้เสียงเป็นตัวขับเคลื่อน (Audio-driven human video generation) ซึ่งเป็นรุ่นต่อยอดจากเวอร์ชัน 1.5 โดยเน้นการแก้ปัญหาเรื่องความไม่เป็นธรรมชาติของการขยับปาก และการรักษาความต่อเนื่องของภาพในวิดีโอที่มีความยาวเกินกว่า 10 นาที
การทำงานของโมเดลนี้ใช้สถาปัตยกรรมที่ช่วยให้การเคลื่อนไหวของใบหน้าและร่างกายสอดประสานกันได้ดีขึ้น รวมถึงมีการเพิ่มประสิทธิภาพในการประมวลผล (Inference) เพื่อให้สามารถนำไปใช้งานจริงได้รวดเร็วและมีประสิทธิภาพมากขึ้น ผู้ใช้สามารถปรับแต่งการสร้างวิดีโอผ่านการผสม LoRA adapters เพื่อควบคุมความเสถียรของโครงสร้างใบหน้าได้ตามต้องการ
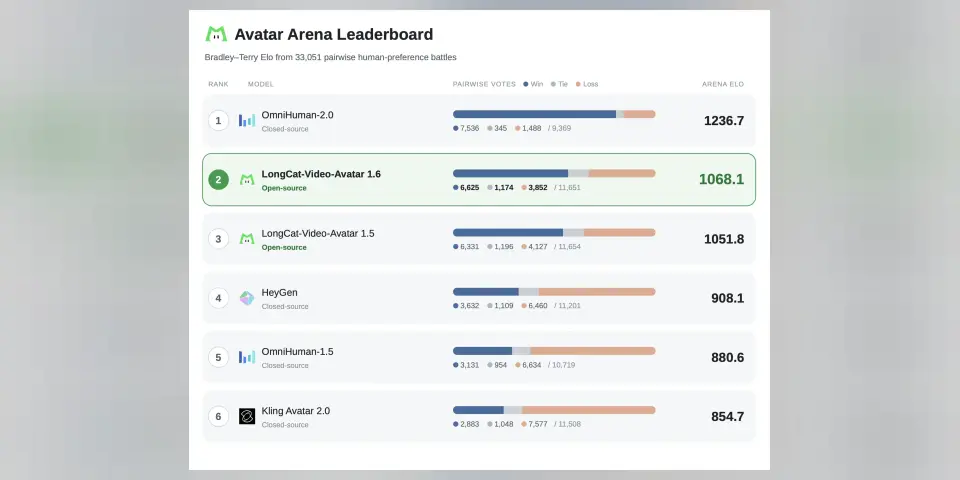
ในแง่ของความน่าสนใจ โมเดลนี้ได้รับการยอมรับอย่างรวดเร็วบน Hugging Face โดยติดอันดับที่ 8 ในหน้าโมเดลที่กำลังมาแรง และมีสถิติการทดสอบผ่านการลงคะแนนจากมนุษย์รวม 33,051 ครั้ง ซึ่งผลลัพธ์ที่ได้มีค่า Bradley–Terry Elo score อยู่ที่ 1068.1 ทำให้เป็นหนึ่งในโมเดลที่ได้รับคะแนนความพึงพอใจในระดับสูงเมื่อเทียบกับระบบเชิงพาณิชย์หลายแห่ง
✨ จุดเด่น
- ปากขยับเป็นธรรมชาติ — ลดปัญหาการขยับปากที่ดูฝืนหรือสีปากที่แดงเกินจริง
- รองรับวิดีโอยาว — สามารถสร้างวิดีโอต่อเนื่องได้นานกว่า 10 นาทีโดยภาพยังคงความเสถียร
- ประมวลผลเร็วขึ้น — ปรับปรุงไปป์ไลน์การทำงานให้รวดเร็วและรองรับการใช้งานบน GPU หลายตัว
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาที่ต้องการสร้างวิดีโอคนพูดด้วย AI โดยต้องมีความรู้ด้านการใช้งาน Python, PyTorch และมีฮาร์ดแวร์ GPU สำหรับการรันโมเดล
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ meituan-longcat/LongCat-Video-Avatar-1.6 — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...