โมเดล OCR ตัวใหม่ที่ออกแบบมาเพื่อการอ่านเอกสารยาวหลายหน้าไปจนถึงระดับร้อยหน้าในคำขอเดียว
baidu/Unlimited-OCR-2 เป็นโปรเจกต์โมเดล AI บน Hugging Face ที่กำลังมาแรง โดยอยู่ในอันดับ #12 ในหน้ากำลังมาแรง ทำยอดดาวน์โหลดไปแล้ว 8,357 ครั้ง และมียอดถูกใจ 324 ครั้ง โปรเจกต์นี้ถูกพัฒนาขึ้นเพื่อแก้ปัญหาการประมวลผลเอกสารขนาดยาวพิเศษ ตั้งแต่ระดับหลายสิบหน้าไปจนถึงหลายร้อยหน้า
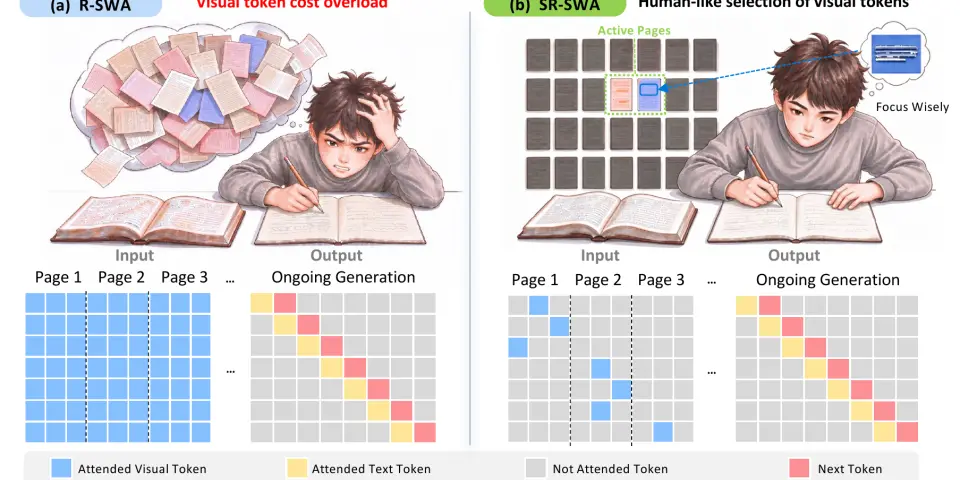
เบื้องหลังการทำงานของโมเดลนี้คือเทคโนโลยี Sparse Reference Sliding Window Attention (SR-SWA) ซึ่งทำหน้าที่บีบอัดปฏิสัมพันธ์ระหว่างข้อความและภาพจากลำดับขนาดยาวให้เหลือชุดอ้างอิงขนาดคงที่ ช่วยควบคุมความซับซ้อนในการคำนวณ ทำให้เวลาในการถอดรหัสและหน่วยความจำคงที่เกือบจะเท่าเดิม ไม่ว่าเอกสารจะมีความยาวแค่ไหนก็ตาม
โมเดลนี้รองรับการทำงานทั้งแบบหน้าเดียวและหลายหน้า พร้อมกันนี้ยังรองรับการใช้งานผ่าน Transformers สำหรับการทดสอบอย่างรวดเร็ว และ SGLang สำหรับการรันเซิร์ฟเวอร์ โดยรองรับ API ที่เข้ากันได้กับ OpenAI อีกด้วย
✨ จุดเด่น
- SR-SWA — เทคโนโลยีบีบอัดความสนใจของภาพและข้อความยาวๆ ให้เหลือชุดอ้างอิงขนาดคงที่เพื่อประหยัดหน่วยความจำ
- Ultra-Long Document Parsing SOTA — ทำผลงานได้ดีเยี่ยมในการทดสอบเอกสารความยาวหลายสิบหน้าและเอกสารความยาวนับร้อยหน้า
- รองรับการใช้งานหลากหลาย — สามารถรันผ่าน Transformers สำหรับการทดสอบ และใช้ SGLang สำหรับการทำ Serving
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาและผู้ใช้งานที่ต้องการประมวลผลเอกสารขนาดยาวหลายสิบถึงร้อยหน้า โดยต้องมีความรู้พื้นฐานในการใช้งาน Python และเครื่องมืออย่าง Transformers หรือ SGLang
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ baidu/Unlimited-OCR-2 — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...