


















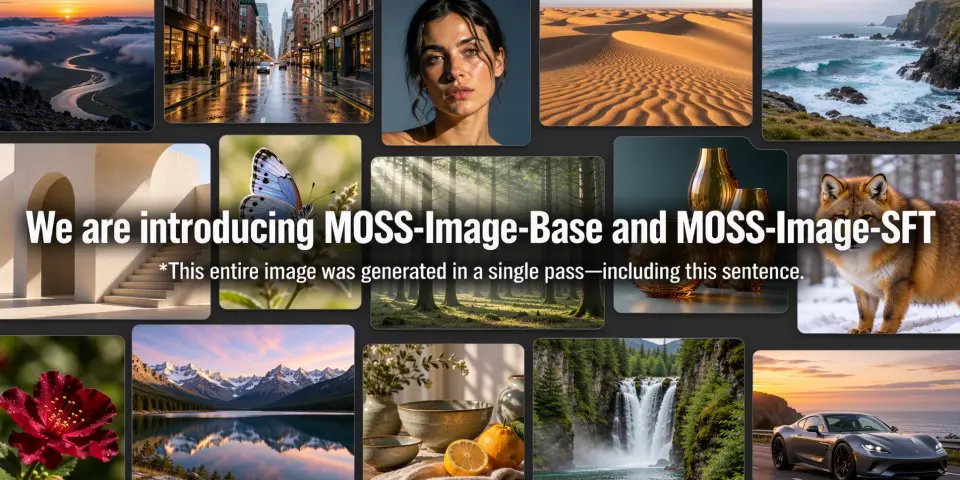
โมเดลสร้างภาพจากข้อความที่โดดเด่นเรื่องการจัดวางเลย์เอาต์และข้อความให้เป็นระเบียบ
MOSS-Image-SFT เป็นโมเดลในตระกูล MOSS-Image จากทีม OpenMOSS ที่ผ่านการทำ Supervised Fine-tuning มาแล้ว โดยเน้นไปที่การสร้างภาพจากข้อความ (text-to-image) ซึ่งจุดเด่นสำคัญคือความสามารถในการควบคุมตำแหน่งของวัตถุและข้อความภายในภาพผ่านการใช้ JSON layout ได้อย่างเป็นระเบียบและชัดเจนกว่ารุ่น Base
การทำงานของโมเดลนี้รองรับทั้งคำสั่งภาษาธรรมชาติ, ชุดของแท็ก ไปจนถึงโครงสร้าง JSON เพื่อกำหนดตำแหน่งข้อความและวัตถุ ผู้ใช้งานสามารถกำหนดค่าต่างๆ เช่น Sampler แบบ Flow-matching Euler, จำนวน Steps ที่ 50 และค่า CFG ที่ 3 โดยโมเดลใช้สถาปัตยกรรมที่รองรับการประมวลผลผ่าน GPU ของ NVIDIA และสามารถใช้งานได้ทั้งผ่าน Python API หรือติดตั้งปลั๊กอินใน ComfyUI
ปัจจุบันโปรเจกต์นี้ได้รับความสนใจบน Hugging Face โดยมียอดดาวน์โหลด 2,087 ครั้ง และมียอดถูกใจ 343 ครั้ง ติดอันดับที่ 11 ในหน้า Trending ของแพลตฟอร์ม นอกจากตัวโมเดลหลักแล้ว ยังมีเครื่องมือเสริมอย่าง MOSS-Image Prompt Enhancer ที่ช่วยเปลี่ยนไอเดียภาพให้เป็นคำบรรยายหรือเลย์เอาต์ที่ละเอียดขึ้นสำหรับนำไปสร้างภาพต่อได้อีกด้วย
✨ จุดเด่น
- ควบคุมเลย์เอาต์ — รองรับการใช้ JSON เพื่อระบุตำแหน่งวัตถุและข้อความในภาพได้อย่างแม่นยำ
- ใช้งานผ่าน ComfyUI — ติดตั้งใช้งานได้สะดวกผ่าน ComfyUI Manager ด้วยปลั๊กอินเฉพาะ
- เครื่องมือช่วยเขียน Prompt — มี Prompt Enhancer ช่วยแปลงไอเดียเป็นคำสั่งแบบละเอียดหรือรูปแบบเลย์เอาต์
- ปรับแต่งได้สูง — รองรับการปรับค่า Sampling และการทำ Layer skipping เพื่อผลลัพธ์ที่ต้องการ
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาหรือผู้ใช้งานสายกราฟิกที่ต้องการควบคุมองค์ประกอบภาพอย่างละเอียด โดยต้องใช้ Python 3.10 ขึ้นไป และการ์ดจอ NVIDIA ที่รองรับ CUDA พร้อม PyTorch 2.9 ขึ้นไป
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ OpenMOSS-Team/MOSS-Image-SFT — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...