โมเดลเสียงพูดและภาษาเปิดน้ำหนัก (Open-weight) จาก NVIDIA ที่รองรับการถอดเสียง แปลภาษา และตอบคำถามจากเสียงความยาวสูงสุด 1 ชั่วโมง
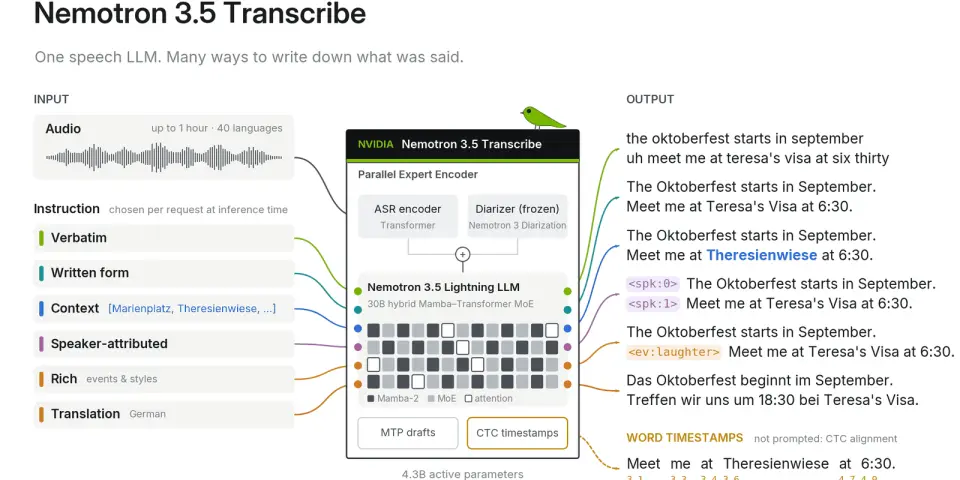
NVIDIA-Nemotron-3.5-Transcribe-30B-A4B เป็นโมเดลเสียงและเสียงพูดแบบออฟไลน์ (Offline) จาก NVIDIA สำหรับการถอดเสียงใน 40 ภาษา รองรับการบันทึกเสียงยาวสูงสุดถึง 1 ชั่วโมง พร้อม context length 65,536 tokens โดยพัฒนาเป็น Speech-Augmented Language Model (SALM) ที่ประมวลผลเสียงร่วมกับคำสั่งข้อความเพื่อทำหน้าที่หลากหลาย เช่น การถอดเสียง แปลภาษา ระบุตัวผู้พูด และการตอบคำถามจากเสียง
โครงสร้างของโมเดลใช้สถาปัตยกรรมแบบ Mamba-2–Transformer hybrid Mixture of Experts ที่ทำงานร่วมกับ Parallel Expert Encoder มีพารามิเตอร์รวม 34B โดยทำงานจริงประมาณ 4.3B พารามิเตอร์ (รวม audio encoder) มีให้เลือกใช้งานในความละเอียดแบบ BF16, FP8 และ NVFP4 และใช้ฮาร์ดแวร์ในการรันอย่างน้อย 1× H100 80 GB
โปรเจกต์นี้ได้รับความสนใจบน Hugging Face ด้วยยอดดาวน์โหลด 4,276 ครั้ง ยอดถูกใจ 362 ครั้ง และติดอันดับ #12 ในหน้าโมเดลกำลังมาแรง เหมาะสำหรับงานที่ต้องการความแม่นยำสูงและการปรับแต่งเพิ่มเติม สามารถใช้งานได้ทั้งในเชิงพาณิชย์และไม่ใช่เชิงพาณิชย์ภายใต้สลาก OpenMDW-1.1
✨ จุดเด่น
- พารามิเตอร์ — มีพารามิเตอร์รวม 34B โดยมีพารามิเตอร์ที่ทำงานใช้งานจริงประมาณ 4.3B รวมถึง audio encoder
- ความยาวเสียง — รองรับการประมวลผลไฟล์เสียงบันทึกความยาวสูงสุด 1 ชั่วโมง ด้วย context length 65,536 tokens
- ความหลากหลายของงาน — รองรับการถอดเสียงใน 40 ภาษา แปลภาษา ระบุตัวผู้พูด และตอบคำถามจากเสียง
🙋 ใครเหมาะจะลอง: เหมาะสำหรับนักพัฒนาหรือผู้ใช้งานที่ต้องการโมเดลถอดเสียงความแม่นยำสูงแบบออฟไลน์ โดยต้องมีทรัพยากรฮาร์ดแวร์ที่เหมาะสม เช่น 1× H100 80 GB สำหรับการรันโมเดล
ทีมข่าว เอไอไทย.com · เรียบเรียงจากหน้าโปรเจกต์ nvidia/NVIDIA-Nemotron-3.5-Transcribe-30B-A4B — รายละเอียดล่าสุดดูที่ต้นทาง
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...