เจาะประเด็น
AI / Systems
ถอดรหัสเบื้องหลังความคุ้มค่าของการรัน AI สเกลใหญ่ด้วย KV Cache
เมื่อการรันโมเดลภาษาให้เสถียรและประหยัดต้นทุน ไม่ได้จบแค่การซื้อการ์ดจอเพิ่ม
ทีมข่าว เอไอไทย.com
⏱ อ่าน 3 นาที
เบื้องหลังแอปพลิเคชัน AI ที่ตอบไวและราคาไม่พุ่งกระฉูด คือสงครามการจัดการหน่วยความจำที่คนนอกวงการมักมองข้าม
พอพูดถึงการรันโมเดลภาษาหรือ LLM ให้บริการคนนับล้าน สิ่งแรกที่หลายคนนึกถึงคงหนีไม่พ้นการทุ่มเงินซื้อฮาร์ดแวร์แรงๆ มาสุมรวมกัน แต่ในความเป็นจริงแล้ว การจัดการระบบเบื้องหลังให้มีประสิทธิภาพและคุมค่าใช้จ่ายได้อยู่หมัดนั้นซับซ้อนกว่านั้นเยอะ
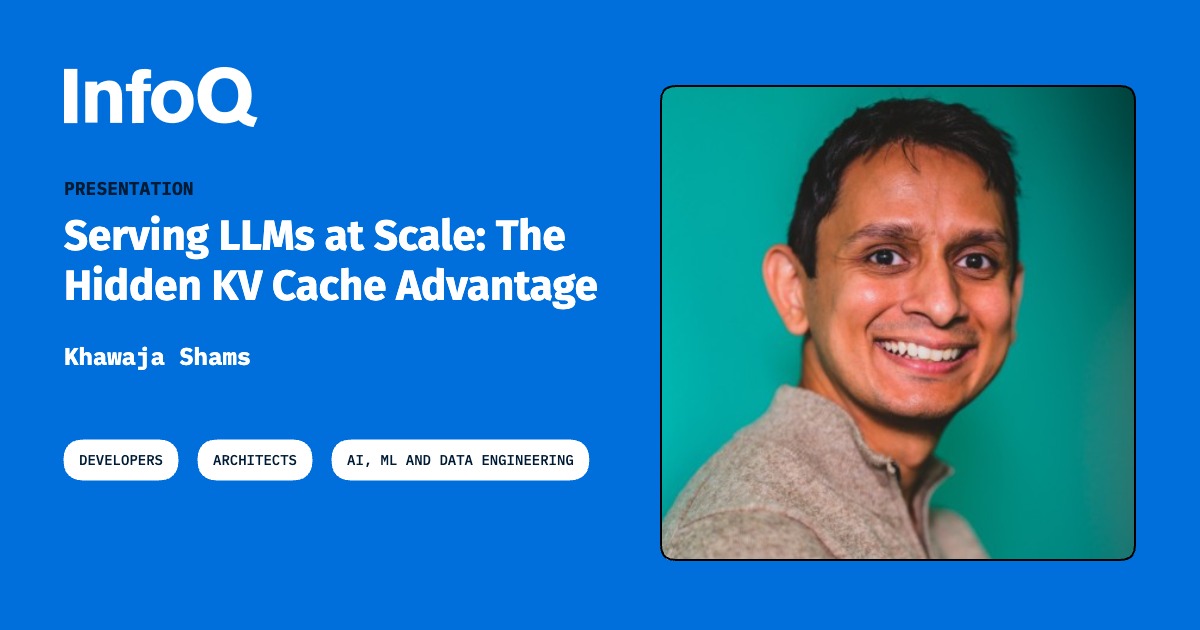
เรื่องนี้ Khawaja Shams ออกมาแชร์มุมมองแบบคนทำระบบกระจายหรือ distributed systems ตัวยง ในงานพูดคุยที่เจาะลึกเรื่องการรัน AI inference ในสเกลระดับอุตสาหกรรม โดยประเด็นที่ชวนให้คิดหนักไม่ใช่แค่เรื่องความเร็วตอนประมวลผล แต่เป็นเรื่องที่ว่าเราจะใช้ประโยชน์จากทรัพยากรที่มีอยู่ให้คุ้มทุกเม็ดได้ยังไง
หัวใจสำคัญที่ถูกหยิบมาพูดถึงคือเรื่องของ KV cache ซึ่งเปรียบเสมือนความจำระยะสั้นของโมเดลเวลาที่มันต้องคิดคำตอบ ถ้าจัดการตรงนี้ไม่ดี หน่วยความจำบนการ์ดจอก็จะเต็มเอี๊ยดจนเกิดอาการที่เรียกว่า memory cliffs ซึ่งทำให้ระบบสะดุดหรือช้าลงแบบหน้ามือเป็นหลังมือ
การจะแก้เกมนี้ให้รอด ทีมพัฒนาเลยต้องมองหากลยุทธ์ใหม่ๆ เช่น การกระจายการจัดเก็บข้อมูลแบบ tiered storage และการปรับสถาปัตยกรรมกระบวนการทำงานให้แยกส่วนระหว่างช่วงเตรียมข้อมูลกับการสร้างคำตอบออกจากกันอย่างเด็ดขาด
การเพิ่มประสิทธิภาพการใช้งาน GPU
ปรับปรุงการใช้ฮาร์ดแวร์ให้คุ้มค่าที่สุดเพื่อรองรับปริมาณงานมหาศาลโดยไม่ต้องเพิ่มต้นทุนเกินจำเป็น
การจัดการหน่วยความจำ KV Cache
รับมือกับปัญหาหน่วยความจำหมดกะทันหันเพื่อป้องกันไม่ให้ระบบสะดุดระหว่างให้บริการจริง
สถาปัตยกรรม Disaggregated Prefill and Decode
แยกขั้นตอนการอ่านบริบทและการเขียนคำตอบออกจากกันเพื่อความยืดหยุ่นและลดอาการหน่วงของระบบ
แนวทางเหล่านี้ไม่ได้ช่วยแค่เรื่องความเร็วในการตอบสนองคำขอที่ช้าผิดปกติหรือ tail latency เท่านั้น แต่ยังส่งผลโดยตรงต่อต้นทุนรวมในการดูแลระบบโครงสร้างพื้นฐานทั้งหมดให้ออนไลน์อยู่ได้ตลอดเวลาแบบไม่มีล่ม
ท้ายที่สุดแล้ว การทำระบบ AI ให้รอดในสเกลใหญ่ไม่ได้วัดกันที่โมเดลตัวไหนฉลาดกว่ากันอย่างเดียว แต่ วัดกันที่เบื้องหลังว่าใครบริหารจัดการภาระของระบบได้เนียนและประหยัดกว่ากันต่างหาก
การรัน AI ให้รอดในสเกลระดับนี้ไม่ใช่เรื่องของกำลังซื้อฮาร์ดแวร์ แต่มันคือสงครามการรีดเค้นประสิทธิภาพจากซอฟต์แวร์และหน่วยความจำล้วนๆ
ที่มา: InfoQ AI/ML — อ่านต้นฉบับ
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...