


















เจาะประเด็น
AI / TTS
Google ปล่อยโมเดลเสียงพูดใหม่ 2 ตัว คลังเสียง 2,000 แบบ โคลนเสียงตัวเองได้จากคลิป 30 วิ
ของเล่นใหม่ที่ทำเอาคนสายเสียงอยากลองทันที เพราะมันเปลี่ยนวิธีคิดเรื่อง "เสียงพากย์" ไปเลย
ทีมข่าว เอไอไทย.com
⏱ อ่าน 4 นาที
ถ้าคุณมีคลิปเสียงตัวเอง 30 วินาที นั่นคือทั้งหมดที่โมเดลนี้ต้องการเพื่อทำให้เสียงคุณพูดทุกอย่างที่พิมพ์
วันนี้ Google เปิดตัวโมเดล text-to-speech ใหม่สองตัวรวด คือ gemini-3.8-flash-tts กับ gemini-3.8-flash-lite-tts ครับ ตัวเลขรุ่นดูแปลกๆ แต่นั่นแหละชื่อมันเป็นแบบนั้น จุดที่คนพูดถึงกันเยอะคือมันมาพร้อมคลังเสียงกว่า 2,000 แบบ และที่เจ๋งกว่านั้นคือสร้างเสียงโคลนจากคลิปเสียงแค่ 30 วินาที ไม่ว่าจะเป็นเสียงของคุณเองหรือเสียงที่คุณมีสิทธิ์ใช้งาน
Simon Willison เจ้าของบล็อกต้นทางข่าวนี้เล่าว่าเขาเอาตัว playground แบบ bring-your-own-key มาลอง vibe code ด้วย GPT-6 Astra โดยใช้ประโยชน์จากนโยบาย CORS แบบเปิดของ Gemini API ตรงนี้ต้องบอกว่าคำว่า "vibe code" กำลังเป็นของจริงในวงการ — คือการให้ AI ช่วยเขียนโค้ดไปเรื่อยๆ จนได้ของที่ใช้งานได้ ไม่ต้องนั่งออกแบบสถาปัตยกรรมอะไรให้ครบก่อน
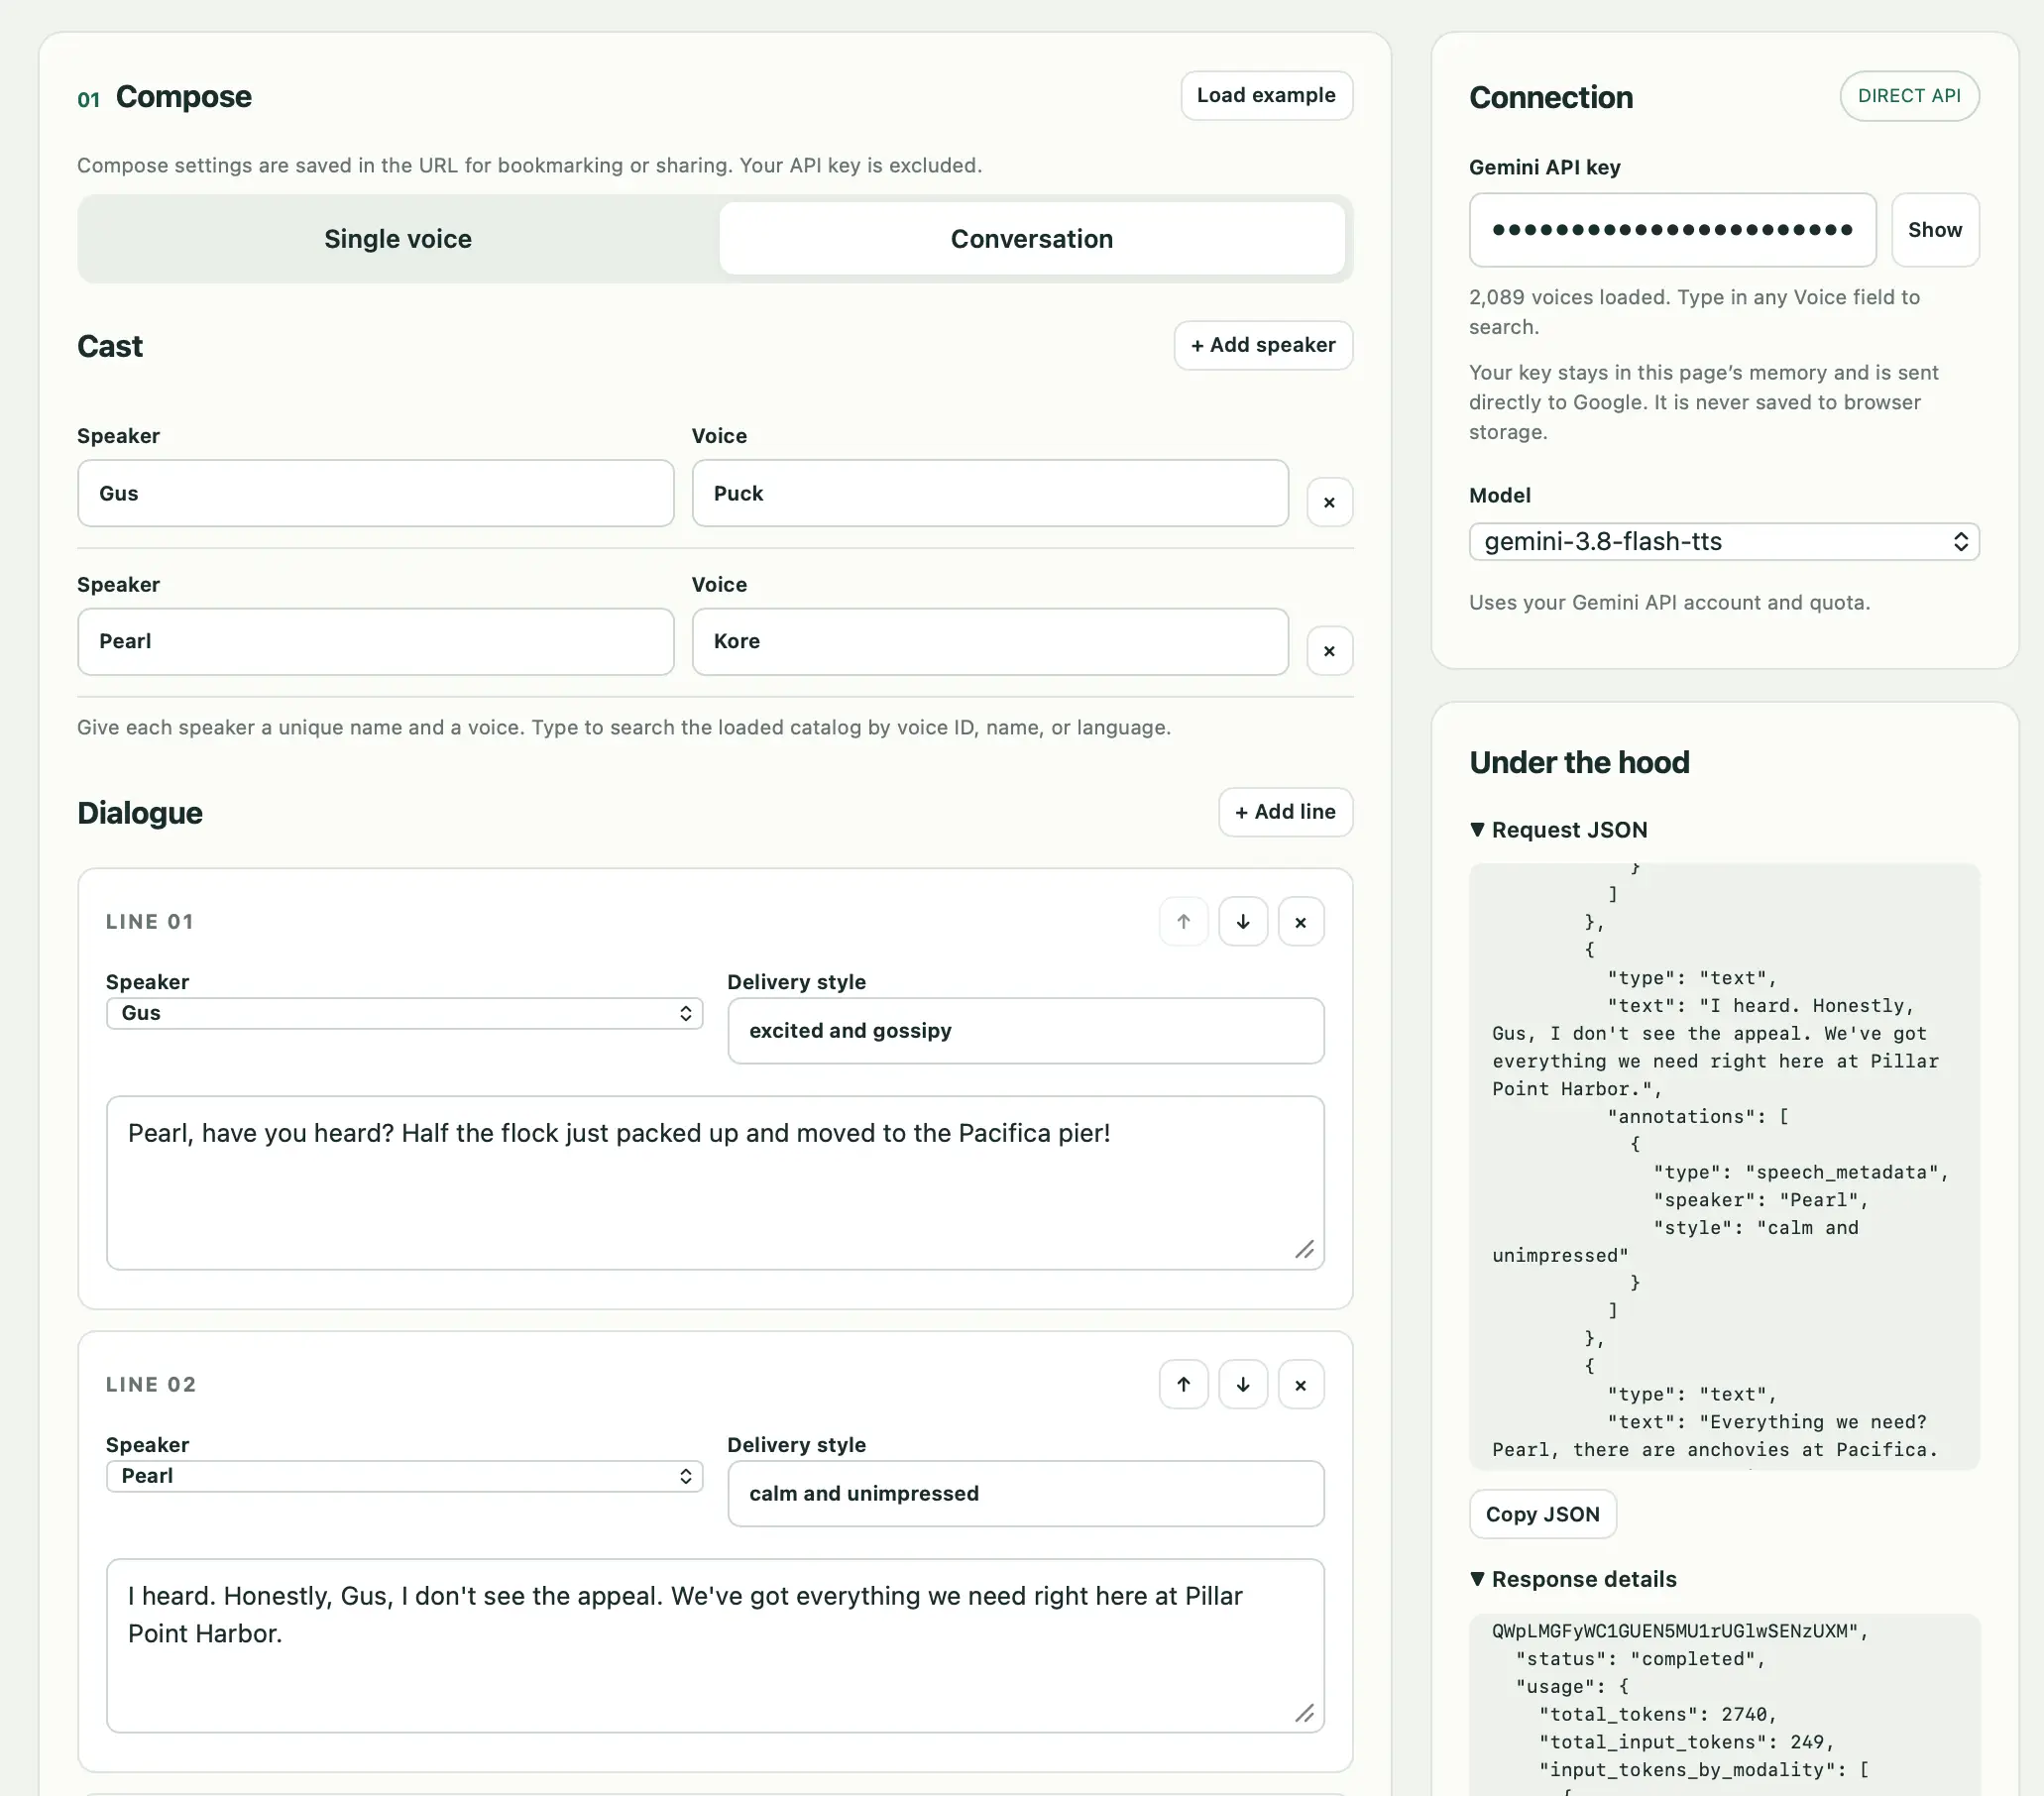
ฟีเจอร์ที่ Simon ชี้ว่าสำคัญมากคือ API นี้ทำให้กำหนดบทสนทนาเต็มรูปแบบระหว่างตัวละครหลายตัวได้ง่ายมาก แต่ละตัวมีเสียงต่างกัน และกำหนดสไตล์การพูดของแต่ละตัวได้ด้วย นี่ไม่ใช่แค่ TTS ทั่วไปที่อ่านข้อความออกมาเป็นเสียง monotone แต่เป็นการสร้างฉากสนทนาที่มีคาแรกเตอร์จริงๆ
เพื่อพิสูจน์ว่าเวิร์กจริง เขาให้ Claude 4.5 Opus เขียนสคริปต์บทสนทนาระหว่างนกกระทุงสองตัวที่เถียงกันว่าจะย้ายไปอยู่ Pacifica Pier ดีไหม แล้วสั่งให้สร้าง URL มาเรนเดอร์ด้วยเครื่องมือนี้ ผลลัพธ์คือคลิปเสียงยาว 1 นาที 18 วินาที ที่ใช้เวลาเจนแค่ราว 20 วินาที ด้วย Gemini 3.8 Flash TTS ตัวเต็ม (ไม่ใช่ Flash-Lite ตัวถูกกว่า) คิดค่าใช้จ่าย 2.74 เซนต์
ลองคิดดูนะ 2.74 เซนต์ หรือประมาณไม่ถึงหนึ่งบาทไทย สำหรับเสียงยาวเกือบหนึ่งนาทีครึ่งที่บอกได้ว่าตัวไหนพูดด้วยโทนไหน นี่มันราคาที่ทำให้คนทำพอดแคสต์ เกม ออดิโอ้บุ๊ก หรือสื่อการเรียนรู้ต้องหยุดคิดเลย
ที่ต้องจับตาคือเรื่อง "30 วินาที" นี่แหละ เพราะเกณฑ์โคลนเสียงเดิมๆ มักต้องใช้ข้อมูลเสียงเยอะกว่านี้มาก การลดลงมาเหลือแค่คลิปสั้นๆ ทำให้กำแพงการเข้าใช้งานต่ำลงมหาศาล แต่ในทางกลับกัน มันก็เปิดประตูให้เรื่อง misuse น่ากังวลขึ้นตามไปด้วย ซึ่ง Simon เองก็เลี่ยงคำว่าโคลนเสียงแบบไม่มีเงื่อนไข ด้วยการย้ำว่าเป็น "เสียงของคุณเองหรือเสียงที่คุณมีสิทธิ์ใช้งาน"
gemini-3.8-flash-tts
ตัวเต็มที่ใช้ในเดโม เน้นคุณภาพเสียง ยอมจ่ายแพงกว่าเล็กน้อยแลกกับผลลัพธ์ที่ดีกว่า
gemini-3.8-flash-lite-tts
ตัวถูกลงสำหรับงานที่ต้องการประหยัดต้นทุนมากกว่าคุณภาพระดับพรีเมียม
คลังเสียง 2,000+ แบบ
ให้เลือกใช้ได้ทันทีไม่ต้องสร้างเอง เหมาะกับงานที่ต้องการความหลากหลายเร็วๆ
กำหนดบทสนทนาหลายตัวละคร
แต่ละตัวเลือกเสียงและสไตล์การพูดแยกกันได้ เหมาะกับละครเสียงและเกม
มุมที่ผมว่าน่าสนใจที่สุดไม่ใช่ตัวโมเดล แต่วิธีที่ Simon ทำงานต่างหาก เขาไม่ได้นั่งเขียนโค้ดเองทั้งหมด แต่ใช้ AI หลายตัวต่อกันเป็นท่อ — ตัวหนึ่งเขียน playground อีกตัวเขียนสคริปต์ อีกตัวเจนเสียง แล้วเอาผลมาเรียงเป็นเดโม แบบนี้กำลังกลายเป็น workflow มาตรฐานของคนทำของเล่นสาย AI ไปแล้ว
ราคา 2.74 เซนต์ต่อเสียงยาวนาทีกว่าๆ คือจุดที่ทำให้ TTS เปลี่ยนจาก "ของเล่น" เป็น "เครื่องมือผลิตจริง" สำหรับคนทำคอนเทนต์ไทย คำถามเดียวที่เหลือคือคุณจะเอาไปใช้ทำอะไรก่อนคู่แข่ง
ที่มา: Simon Willison's Weblog — อ่านต้นฉบับ
ความคิดเห็น 3
กำลังโหลดความคิดเห็น...