


















เจาะประเด็น
AI / LLM
เทนเซ็นต์ปล่อยโมเดล 770B อัดคอนเทกซ์ 1 ล้านโทเคน แต่มีโหมด "ไม่คิด" ให้เลือกด้วย
Hy4 มาแรงขนาดไหน ไปดูกันว่าโมเดลใหม่จากจีนตัวนี้ต่างจากรุ่นก่อนยังไง และทำไมการมีปุ่ม "ปิดสมอง" ถึงน่าสนใจกว่าเลขพารามิเตอร์
ทีมข่าว เอไอไทย.com
⏱ อ่าน 3 นาที
สงสัยมานานแล้วว่าโมเดลจีนเวลาคิดในใจใช้ภาษาแบบไหน — คำตอบคือมันคิดแบบ "สั้น กระชับ ไม่เสียเวลากับไวยากรณ์" เหมือนคนที่ทำงานจนไม่มีเวลามานั่งแต่งประโยค
คุ้นๆ กันดีกับโมเดลเปิดจากจีนที่มาทีละตัวใหญ่ๆ แต่รอบนี้เทนเซ็นต์ทำอะไรที่มันเกินคาดไปอีกขั้น — Hy4 โมเดลภาษาแบบ text input ล้วนๆ (ไม่มี vision) มาในขนาด 770B พารามิเตอร์รวม แต่ใช้งานจริงแค่ 49B ผ่านเทคนิค MoE (Mixture of Experts) คอนเทกซ์ยาวถึง 1 ล้านโทเคน และขนาดไฟล์บน Hugging Face โตไปถึง 1.56TB เลยทีเดียว
เทียบให้เห็นภาพ — รุ่นก่อนหน้าอย่าง Hy3 ที่เพิ่งปล่อยไปเมื่อกรกฎาคม ยังอยู่ที่ 295B พารามิเตอร์รวม 21B แอ็กทีฟ คอนเทกซ์ 256K และไฟล์ 598GB เท่านั้น นี่คือการอัปเกรดที่กระโดดข้ามขั้นจริงๆ ไม่ใช่แค่เก็บงานเก่ามาแต่งหน้า
ซิมอน วิลลิสัน (Simon Willison) นักพัฒนาและบล็อกเกอร์สาย AI ที่หลายคนติดตาม ไปสะดุดตากับอะไรบางอย่างในไฟล์ chat_template.jinja ของโมเดลนี้ — มันมีตัวเลือกเรื่อง "ระดับการใช้เหตุผล" แค่สองแบบเท่านั้น: high (ค่าเริ่มต้น) กับ no_think (ปิดการคิด)
ฟังดูเหมือนเรื่องเล็ก แต่จริงๆ คือสัญญาณว่าเทนเซ็นต์กำลังทดสอบแนวคิดที่ว่า "โมเดลควรคิดเสมอไหม?" — บางคำถามมันไม่ต้องใช้เหตุผลซับซ้อนเลย เช่น ถามเวลาหรือขอให้แปลประโยคง่ายๆ การบังคับให้โมเดลคิดทุกครั้งก็แค่เปลืองทรัพยากรและช้าโดยใช่เหตุ
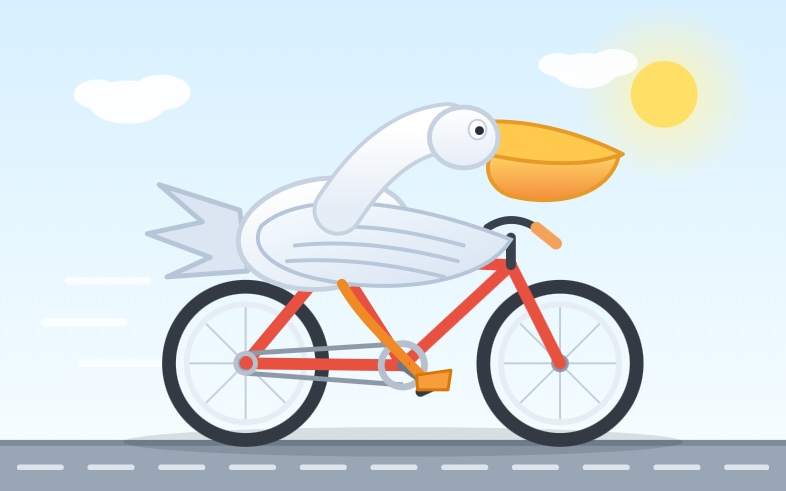
วิลลิสันลองเทสต์ด้วยโพรงเดิมที่เขาชอบใช้ — สั่งให้สร้าง SVG นกกระทุงขี่จักรยาน — แล้วเปิดดู reasoning trace ที่โมเดลคิดก่อนตอบ สิ่งที่เจอคือมันคิดเป็นภาษาอังกฤษที่ "ตัดทอน" ผิดหลักไวยากรณ์เล็กน้อย ไม่ได้เรียงประโยคสวยงามแบบที่คนเขียน
ประเด็นนี้แหละที่น่าสนใจ — เพราะถ้ามองในมุมประสิทธิภาพ การที่โมเดลคิดแบบ "สั้น กระชับ ไม่เสียเวลากับความถูกต้องทางภาษามากนัก" มันสมเหตุสมผลสุดๆ เพราะ reasoning trace ไม่ได้มีไว้ให้คนอ่าน มันคือพื้นที่ทำงานภายในของโมเดล ยิ่งเปลืองโทเคนกับไวยากรณ์ก็ยิ่งช้าและแพงโดยใช่เหตุ
สิ่งที่ผมคิดว่าเทนเซ็นต์กำลังทำคือการสร้างโมเดลที่ "ยืดหยุ่นตามงาน" — ถ้างานง่ายก็ไม่ต้องคิดให้เสียเวลา ถ้างานยากก็คิดเต็มที่ ซึ่งเป็นแนวทางที่ต่างจาก OpenAI หรือ Anthropic ที่มักบังคับให้โมเดลคิดเสมอ (หรือแทบจะตลอด) ในโมเดล reasoning รุ่นใหม่ๆ
แน่นอนว่ายังต้องรอดูว่าโหมด no_think ให้คุณภาพคำตอบดีพอไหม เพราะถ้าปิดการคิดแล้วตอบพลาดบ่อยๆ มันก็ไม่ต่างอะไรกับปุ่ม "ลดคุณภาพ" ที่ไม่มีใครอยากกด แต่ถ้ามันทำงานได้จริง — โดยเฉพาะกับงานง่ายๆ ที่ไม่ต้องใช้ตรรกะซับซ้อน — นี่อาจเป็นจุดเริ่มต้นของเทรนด์ใหม่ที่โมเดลจะฉลาดเลือกเองว่า "เรื่องนี้ควรคิดหรือไม่ควรคิด"
770B รวม / 49B แอ็กทีฟ
ใหญ่กว่า Hy3 เกือบ 3 เท่า แต่ใช้ทรัพยากรจริงแค่ส่วนน้อยด้วยเทคนิค MoE
คอนเทกซ์ 1 ล้านโทเคน
อ่านหนังสือได้ทั้งเล่มในรอบเดียว — จากเดิม 256K ใน Hy3 ถือว่าเพิ่มมาเยอะพอสมควร
โหมดคิด 2 ระดับ: high / no_think
เลือกได้ว่าจะให้โมเดลคิดหนักหรือไม่คิดเลย — เป็นดีไซน์ที่ต่างจากค่ายตะวันตก
อีกเรื่องที่ต้องจับตาคือขนาดไฟล์ 1.56TB — นี่ไม่ใช่โมเดลที่รันบนเครื่องทั่วไปได้แน่นอน ต้องใช้เซิร์ฟเวอร์หลายตัวหรืออย่างน้อยก็เครื่องที่มี VRAM มหาศาล ซึ่งหมายความว่าคนทั่วไปจะเข้าถึงผ่าน API เป็นหลัก เช่น OpenRouter ที่วิลลิสันใช้ทดสอบ
แต่ก็อดคิดไม่ได้ว่าเทนเซ็นต์ปล่อยโมเดลใหญ่ขนาดนี้ออกมาเปิดให้ดาวน์โหลดฟรีบน Hugging Face — แถมเป็น open weight — มันคือการส่งสัญญาณว่าจีนยังไม่หยุดพัฒนา และพร้อมจะแข่งในสนามโมเดลเปิดกับ Meta และ Mistral ไปยาวๆ
Hy4 คือหมัดต่อไปของเทนเซ็นต์ที่ไม่ได้มาเล่นๆ — ทั้งขนาด คอนเทกซ์ และดีไซน์เรื่องโหมดคิด แสดงว่าเค้าจริงจังกับการเป็นผู้เล่นหลักในตลาดโมเดลเปิด และการมีปุ่ม "ไม่คิด" อาจเป็นไอเดียที่ค่ายอื่นต้องกลับไปคิดใหม่ เพราะบางคำถามมันไม่ควรต้องแลกเวลากับเหตุผลที่ยืดเยื้อเลย
ที่มา: Simon Willison's Weblog — อ่านต้นฉบับ
ความคิดเห็น 4
กำลังโหลดความคิดเห็น...