


















เจาะประเด็น
AI / LLM
Claude Fable 5.1 ใช้เงิน $3.30 วาดนกกระทุงขี่จักรยานได้สวยสุดเท่าที่ Anthropic เคยมีมา
เบนช์มาร์กวิทยาศาสตร์พุ่งปรี๊ด แต่ที่คนสนใจจริงคือมันทำ SVG นกกระทุงได้ดีแค่ไหน — คำตอบคือโคตรดี ถ้าคุณยอมจ่าย
ทีมข่าว เอไอไทย.com
⏱ อ่าน 5 นาที
โมเดล AI ที่เก่งขนาดนี้ มันไม่ได้แค่ "ฉลาดขึ้น" แต่มันเริ่มคิดเป็นขั้นตอนเหมือนวิศวกรจริงๆ — คำถามคือเราพร้อมจ่ายค่า "ความคิด" นั้นไหวไหม?
วันนี้เป็นวันเปิดตัว Claude Fable 5.1 (และ Mythos 5.1) อย่างเป็นทางการ Anthropic โฆษณาว่ามัน "สร้างมาตรฐานใหม่สำหรับการเขียนโค้ด งานที่ต้องใช้ความรู้ และงานแก้ปัญหาที่ต้องใช้เวลายาวนาน" — ฟังดูหรูหราใช่ไหมล่ะ? แต่ที่คนในวงการ AI ฮือฮากันจริงๆ ไม่ใช่ benchmark วิทยาศาสตร์ที่พุ่งทะยาน แต่เป็นคำถามง่ายๆ ที่ Simon Willison นักพัฒนาและบล็อกเกอร์ชื่อดังตั้งขึ้นว่า "แล้วมันวาดนกกระทุงขี่จักรยานได้สวยแค่ไหน?"
ก่อนอื่น มาดูตัวเลขกันหน่อย Anthropic อ้างว่า Fable 5.1 ทำคะแนน 52.6% บน benchmark ใหม่ล่าสุดชื่อ Terminal-Bench-Science 0.1 (เพิ่งประกาศครั้งแรกเมื่อ 27 สิงหาคม) เทียบกับ Fable 5 ที่ทำได้ 24.7% Opus 5 ได้ 29.0% และ GPT-5.6 Sol ได้ 22.4% — นี่คือการก้าวกระโดดครั้งใหญ่จริงๆ ตัวเลขอื่นๆ ก็ดีขึ้นเล็กน้อย แต่ไม่มีอะไรสวยงามเท่าตัววิทยาศาสตร์นี่แหละ
แต่เดี๋ยวก่อน — พวกเราที่ตามข่าว AI มาสักพักจะรู้จัก "pelican benchmark" (เบนช์มาร์กนกกระทุง) ที่ Simon คิดค้นขึ้นเมื่อปี 2025 มันคือการให้โมเดลสร้าง SVG นกกระทุงขี่จักรยาน เพื่อวัดความสามารถด้านการมองเห็นและการเขียนโค้ดเชิงสร้างสรรค์ ย้อนกลับไปเดือนกรกฎาคม Simon เขียนไว้ว่าเขาเริ่มหมดศรัทธาใน benchmark นี้แล้ว เพราะความสัมพันธ์ระหว่างความสามารถในการวาดนกกระทุงกับความเก่งด้านอื่นๆ ของโมเดลมันไม่ชัดเจนเหมือนปี 2025 แล้ว สิ่งที่น่าสนใจตอนนี้คือการเปรียบเทียบภายในตระกูลโมเดลเดียวกัน และการเปรียบเทียบ prompt เดียวกันที่ระดับ "การใช้เหตุผล" (reasoning effort) ต่างกัน
Fable 5.1 มีระดับการใช้เหตุผล 5 ระดับ: low, medium, high, xhigh และ max — และที่สำคัญคือไม่มีตัวเลือกให้ปิดการใช้เหตุผลทั้งหมด Simon เลยจัดการแก้บั๊กใน llm-anthropic ที่ทำให้ reasoning traces (บันทึกการคิดของโมเดล) ไม่ถูกบันทึก แล้วก็เริ่มทดสอบทันที
เริ่มจากระดับ low และ medium — ปริศนาอย่างแรกคือ ทั้งคู่ไม่แสดง reasoning tokens เลยแม้แต่ตัวเดียว ระดับ low ใช้ output 1,998 tokens ใช้เวลา 23.8 วินาที เสียค่าใช้จ่าย 10.017 เซนต์ ส่วนระดับ medium ใช้ output 1,977 tokens (น้อยกว่า low เสียอีก!) เวลา 23 วินาที ค่าใช้จ่าย 9.912 เซนต์ — สรุปคือสำหรับ prompt "Generate an SVG of a pelican riding a bicycle" ระดับ low และ medium มันข้ามการใช้เหตุผลไปเลยทั้งคู่
ขึ้นมาที่ระดับ high — 29.6 วินาที 2,612 output tokens 13.087 เซนต์ คราวนี้เริ่มมีการคิดบ้าง แต่ก็สั้นมาก แค่ประมาณว่า "วางแผน layout SVG สำหรับนกกระทุงขี่จักรยาน มีพื้นหลังเป็นท้องฟ้าและพื้นดิน จักรยานสองล้อ โครง เบาะ แฮนด์ และนกกระทุงตัวขาวคอยาวปากสีส้มอยู่ด้านบน" — ไม่ต่างจาก low/medium เท่าไหร่
พอถึงระดับ xhigh ทุกอย่างเปลี่ยนไปสุดขั้ว — 36,767 output tokens ใช้เวลา 7 นาที 51 วินาที ค่าใช้จ่าย $1.83! reasoning trace ยาวเป็นบทความ มีรายละเอียดแบบ "เพิ่มตา ปีกยื่นลงมาถึงแฮนด์ ขาสีส้มเหยียบถึงบันได หางเล็กๆ โดยตั้งใจให้นกกระทุงตัวใหญ่เกินจักรยานเพื่อความตลก" และที่เด็ดคือ "ฉันจะยอมรับความหนาเล็กน้อยว่ามันน่ารักดี แทนที่จะคิดว่ามัน overengineering" — โมเดลมันเริ่มมีรสนิยมเป็นของตัวเองแล้วนะเนี่ย
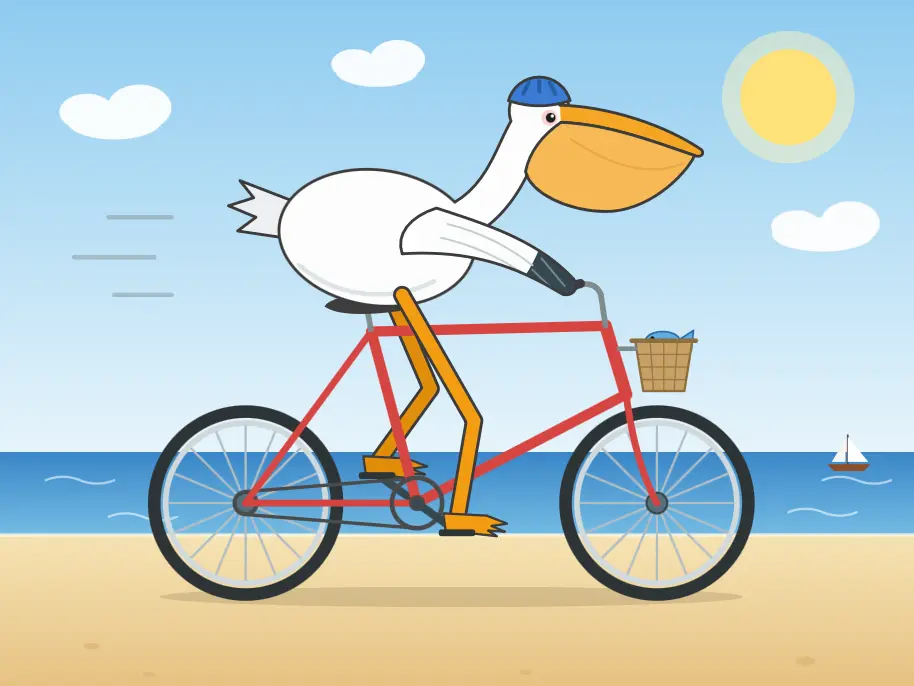
แล้วก็มาถึงระดับ max — 65,927 output tokens ใช้เวลา 13 นาที 54 วินาที ค่าใช้จ่าย $3.30 และได้ผลลัพธ์คือนกกระทุงที่ดีที่สุดเท่าที่ Simon เคยเห็นจากโมเดล Anthropic ทั้งหมด พื้นหลังสวยงาม ขาทั้งสองข้างอยู่คนละฝั่งของโครงจักรยานชัดเจน เท้าเหยียบบันได ปีกวางบนแฮนด์ นกใส่หมวกสีฟ้าน่ารัก และมีตะกร้าหน้าพร้อมปลา! ยังไม่มีความสร้างสรรค์เท่า Gemini 3.7 Flash แต่ Simon ไม่ได้ขอความสร้างสรรค์ เขาขอ SVG และได้ SVG กลับมา
ไฮไลต์จาก reasoning trace ของระดับ max นั้นโคตรละเอียด — มันถกเถียงกับตัวเองว่าจะใส่ผ้าพันคอหรือหมวกแก๊ปดี "แต่เอียงไปทางการรักษาความเรียบง่ายเพื่อไม่ให้รก" แล้วก็คิดเรื่องหมวกกันน็อกจักรยานกับหงอนนกกระทุง "จะดีไหมถ้าใส่หมวกกันน็อก? แต่มันอาจชนกับหงอนที่บ่งบอกความเป็นนกกระทุง" จากนั้นก็คิดเรื่องเส้นโค้งของซี่ล้อ เรื่องมุมของตะเกียบหน้า เรื่องการวาง vent บนหมวกกันน็อก — นี่มันไม่ใช่แค่การ generate รูปแล้ว มันคือกระบวนการคิดแบบวิศวกรจริงๆ
ประเด็นที่ทำให้คอลัมน์นี้สนุกไม่ใช่แค่ "โมเดลใหม่เก่งขึ้น" แต่อยู่ที่การตัดสินใจของ Simon หลังเห็นนกกระทุงระดับ max — มีคนใน Hacker News ชื่อ swalsh คอมเมนต์ว่า "เมื่อ benchmark นี้แก้ได้แล้ว ขอเวอร์ชันแอนิเมชันได้ไหม?" Simon ไม่ยอมจ่ายอีก $3 แต่ใช้วิธีฉลาดๆ คือเอาผลลัพธ์ระดับ max ไปป้อนกลับเข้าโมเดลด้วยระดับการคิด default ที่เป็น high พร้อมคำสั่ง "animate this" — ใช้ input 6,121 tokens output 26,201 tokens ค่าใช้จ่าย $1.37 ผลลัพธ์ที่ได้คือแอนิเมชันนกกระทุงขี่จักรยานที่ล้อหมุน (แม้ทิศทางจะผิดก็ตาม) แต่โดยรวมสวยงามมาก
บทเรียนจาก $4.67 ที่ Simon จ่าย
การใช้จ่ายกับระดับ reasoning สูงๆ ไม่ได้ให้แค่ผลลัพธ์ที่ดีขึ้น แต่ให้ "กระบวนการคิด" ที่เราอ่านแล้วเข้าใจว่าโมเดลตัดสินใจยังไง — นี่คือสิ่งที่ไม่มี benchmark ไหนวัดได้
ความหมายของ "การคิด" ในบริบท AI
ระดับ low และ medium ข้ามการคิดทั้งหมดใน prompt นี้ แต่ระดับ xhigh ใช้เวลา 8 นาทีคิดละเอียดยิบ — คำถามคือผู้ใช้ทั่วไปจะยอมจ่ายแพงขึ้นเพื่อคุณภาพที่ต่างกันขนาดนี้ไหม
ทิศทางของ Anthropic
การที่ Fable 5.1 ไม่มีตัวเลือกปิด reasoning เลย บอกชัดว่า Anthropic มองว่าการคิดคือค่าเริ่มต้นของอนาคต — แต่ค่าใช้จ่าย $3.30 ต่อภาพเดียว มันยั่งยืนสำหรับผู้ใช้ทั่วไปจริงหรือ?
ผมมองว่า Fable 5.1 ไม่ได้แค่ "วาดรูปเก่งขึ้น" แต่มันแสดงให้เห็นว่าโมเดลเริ่มมีกระบวนการคิดเชิงวิศวกรรมจริงๆ — ถกเถียงกับตัวเองเรื่องความสมดุลระหว่างความสวยกับความซับซ้อน ตัดสินใจอย่างมีเหตุผล — แต่คำถามใหญ่คือเราจะใช้มันยังไงให้คุ้มกับค่าใช้จ่ายที่สูงขึ้นเรื่อยๆ เพราะถ้าทุก prompt ต้องจ่าย $3 เพื่อให้ได้คำตอบที่ดีที่สุด มันก็ไม่ต่างจากการจ้างวิศวกรคนหนึ่ง — และนั่นอาจเป็นเป้าหมายจริงๆ ของ Anthropic ก็ได้
ที่มา: Simon Willison's Weblog — อ่านต้นฉบับ
ความคิดเห็น 6
กำลังโหลดความคิดเห็น...