


















เจาะประเด็น
AI / LLM
ถามโพรงเดียว 11 โมเดลตอบไม่เหมือนกัน — นี่คือบทเรียนราคาแพงที่คนใช้ AI ต้องเจอ
อย่าหลงเชื่อว่า AI ทุกตัวฉลาดเท่ากัน เพราะป้อนพรอมป์เดียวกัน แต่มันตีความคนละทิศคนละทาง
ทีมข่าว เอไอไทย.com
⏱ อ่าน 4 นาที
เรื่องนี้มันไม่ได้เกี่ยวกับว่าโมเดลไหน "เก่งกว่า" หรือ "โง่กว่า" แต่มันคือการย้ำเตือนว่าเรากำลังเล่นเกมกับระบบที่คิดไม่เหมือนมนุษย์ และถ้าใครยังเข้าใจผิดคิดว่า AI ทุกตัวคือเครื่องมือที่ให้คำตอบเดียวกัน ยิ่งใช้เยอะก็ยิ่งเจ็บตัวเยอะ
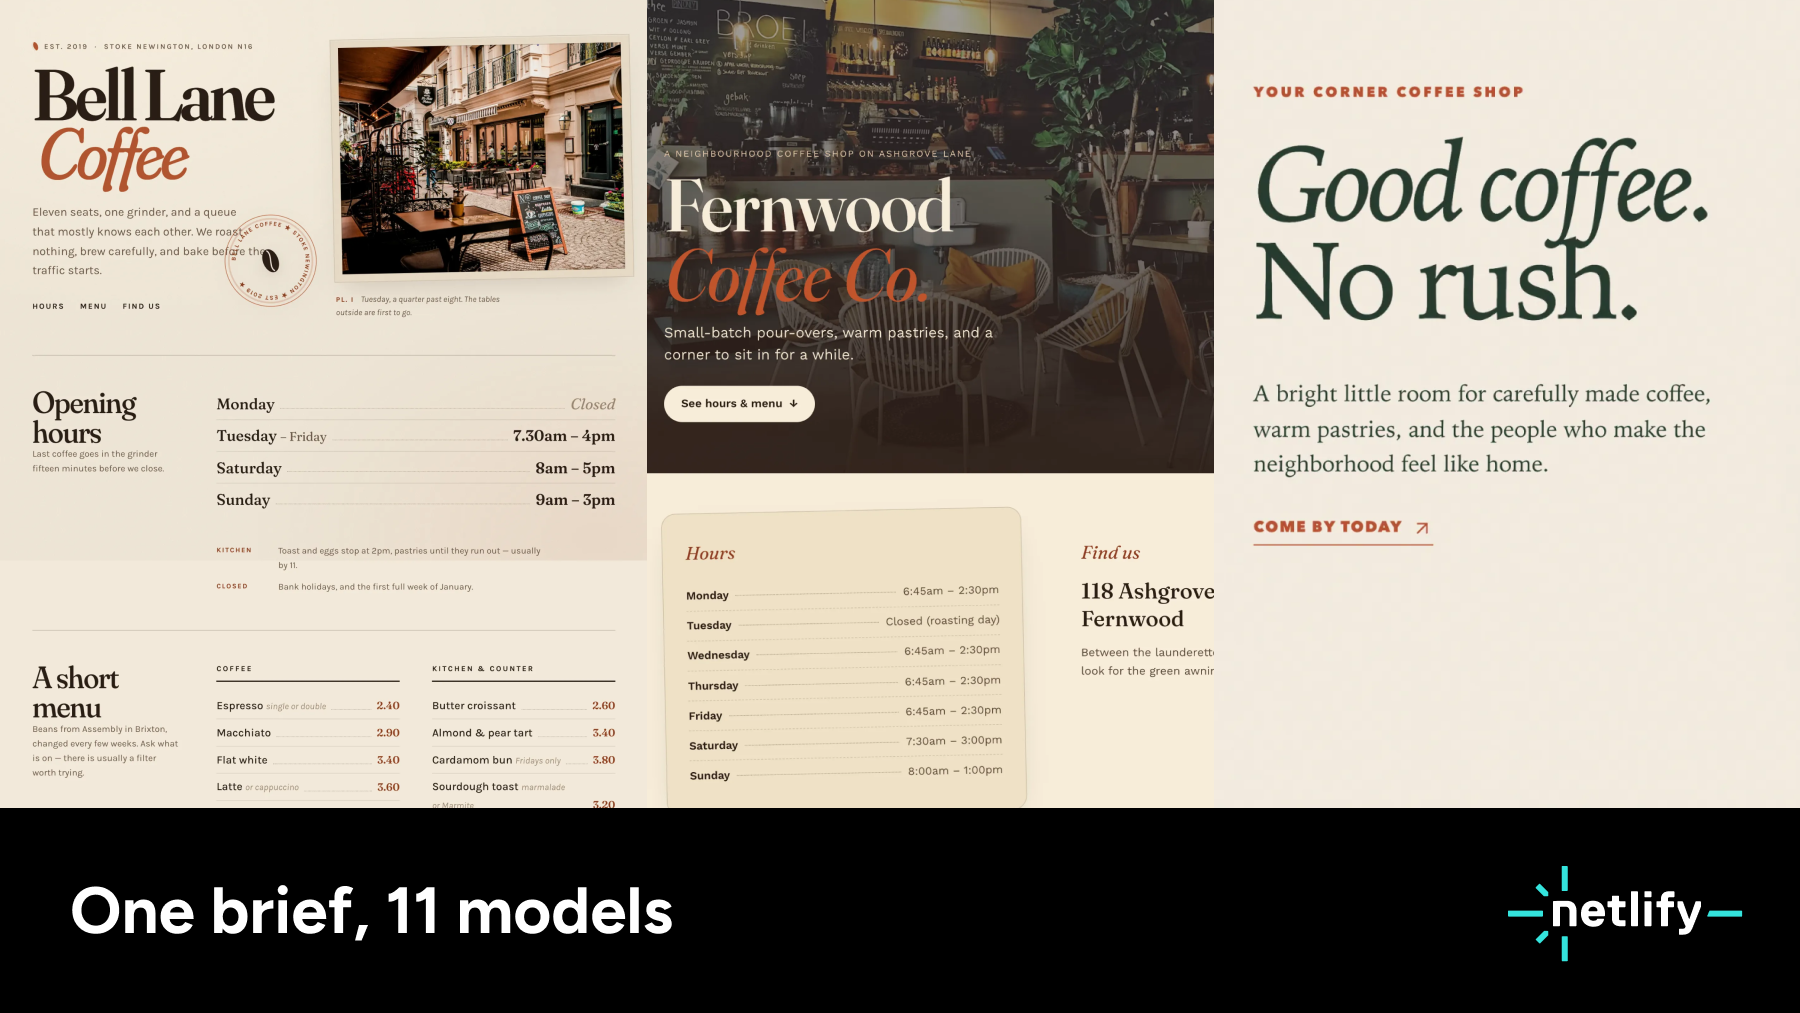
Netlify เขาทำการทดลองง่ายๆ แต่โหดมาก — เอาพรอมป์เดียวกันเป๊ะๆ ส่งให้โมเดล 11 ตัวตอบ แล้วเอาผลลัพธ์มาเทียบกัน ผลที่ได้คือความวุ่นวายสุดขั้ว บางตัวตอบได้ตรงประเด็นราวกับอ่านใจเรา บางตัวเพ้อเจ้อจนอยากปิดหน้าจอ นี่ไม่ใช่เรื่องน่าขำ แต่คือปัญหาจริงที่นักพัฒนาต้องเผชิญทุกวัน
ฟังดูเหมือนเรื่องง่ายๆ ใช่ไหม? ก็แค่ถามคำถามเดียวกันแล้วดูว่าใครตอบดีที่สุด แต่มันซ่อนประเด็นลึกกว่านั้นมาก — เพราะในโลกจริง เราไม่มี "คำตอบเฉลย" ให้เทียบ โมเดลแต่ละตัวถูกเทรนด้วยข้อมูลต่างกัน ปรับจูนต่างกัน มีบุคลิกต่างกัน ผลลัพธ์ที่ออกมาจึงไม่ใช่แค่ "ถูกหรือผิด" แต่คือ "แบบแผนการคิด" ที่แตกต่างกันโดยสิ้นเชิง
ทีมงาน Netlify เขาไม่ได้ตั้งใจจะทำ benchmark อะไรยิ่งใหญ่ แค่สงสัยว่าโมเดล AI ยอดนิยมในตอนนี้ — ตั้งแต่ Claude, GPT, Llama ไปจนถึงรุ่นเล็กๆ — จะตอบพรอมป์เดียวกันยังไงบ้าง ผลปรากฏว่าคำตอบที่ได้แทบจะเรียกว่า "คนละเรื่อง" เลยทีเดียว บางโมเดลเข้าใจเจตนาที่แท้จริงของคำถามได้ดีงาม แต่บางตัวดันไปโฟกัสกับรายละเอียดปลีกย่อยที่ไม่ได้ถูกถาม แล้วตอบแบบหลงทาง
ประเด็นสำคัญไม่ได้อยู่ที่ว่าใครชนะ แต่อยู่ที่ว่า "ความไม่แน่นอน" นี้คือความเสี่ยงที่แท้จริงของคนที่นำ AI ไปใช้ในโปรดักชัน ถ้าคุณเป็นนักพัฒนาที่กำลังเลือกโมเดลไปใช้ในแอปของตัวเอง คุณจะเชื่อใจตัวไหนได้ในเมื่อผลลัพธ์มันสุ่มขนาดนี้?
การทดลองนี้สะท้อนอะไรบางอย่างที่คนในวงการ AI ชอบเมิน — นั่นคือ "พรอมป์เดียวกันไม่ได้แปลว่าคำถามเดียวกัน" เพราะแต่ละโมเดลมี "โลกทัศน์" ที่ถูกหล่อหลอมจากข้อมูลเทรนนิ่งต่างกัน มันเหมือนถามคน 11 คนที่โตมาจากวัฒนธรรมต่างกันว่า "อะไรคือความสำเร็จ" แล้วหวังว่าคำตอบจะเหมือนกัน นั่นแหละคือความผิดพลาดของความคิด
สำหรับนักพัฒนาที่จริงจัง ข้อสรุปมันชัดเจนมาก: ห้ามเลือกโมเดลจากชื่อเสียงหรือกระแส แต่ต้องทดสอบกับโจทย์จริงของตัวเองเสมอ และที่สำคัญกว่านั้น ต้องออกแบบระบบให้รองรับความผิดพลาดของโมเดลได้ อย่าคิดว่า AI จะตอบถูกเสมอ เพราะมันไม่ได้ฉลาดขนาดนั้น — แค่ฉลาดพอที่จะทำให้คุณหลงเชื่อ
ฟันธงเลย — ถ้ายังคิดว่า AI ทุกตัวเท่ากันและเลือกใช้แบบมั่วๆ คุณกำลังสร้างระเบิดเวลาทางเทคนิคให้โปรเจกต์ตัวเอง ไม่มีโมเดลไหน "ดีที่สุด" มีแต่โมเดลที่ "เหมาะกับงานของคุณที่สุด" เท่านั้น เลือกให้เป็น ไม่งั้นเดี๋ยวเจอเองตอนโปรดักชันล่ม
ที่มา: Hacker News — อ่านต้นฉบับ
ความคิดเห็น 4
กำลังโหลดความคิดเห็น...