


















เจาะประเด็น
Database
แฮร์เปอร์ชี้ชัด "หลายระบบ" คือทางตัน ปล่อย 5.2 เครื่องยนต์เดียวจบแรงกว่า
เบนช์มาร์กกับสแตกเวอร์เซลเป็นตัวเลขที่คนต้องคิดหนัก เมื่อสถาปัตยกรรมแบบเดิมๆ กำลังแพ้ให้กับ "เก็บโค้ดและข้อมูลไว้ที่เดียวกัน"
ทีมข่าว เอไอไทย.com
⏱ อ่าน 4 นาที
ถ้าเราต้องยอมรับว่า "การย้ายข้อมูลไปมา" คือต้นตอของความช้า แล้วทำไมเรายังออกแบบระบบให้ต้องวิ่งข้ามบ้านไปเอาข้อมูลทุกครั้ง?
เรื่องนี้มันไม่ได้เกี่ยวกับ "ฐานข้อมูลตัวใหม่" ธรรมดาๆ นะ แต่คือการตั้งคำถามกับวิธีคิดทั้งระบบของวงการ dev ที่เราคุ้นเคยกันมาหลายปี — การแยก application ออกจาก database แล้ววิ่งขอข้อมูลผ่าน network ทีละรอบ มันคือของดีจริงหรือเปล่า? แฮร์เปอร์ (Harper) เค้าตอบชัดเจนว่า "ไม่" และเค้าทำเบนช์มาร์กมาให้ดูเป็นหลักฐาน ไม่ใช่แค่โม้
พูดให้เข้าใจง่ายแบบเพื่อนเล่าให้ฟัง — สแตกที่เราคุ้นเคยกันดี เช่น ฝั่งหนึ่งเป็น Vercel สำหรับรันโค้ด อีกฝั่งเป็นฐานข้อมูลแยกต่างหาก มันเหมือนการสร้างบ้านสองหลังแล้วเดินไปมาหากันทุกครั้งที่อยากได้ของ แน่นอนว่ามันทำงานได้ แต่ทุกก้าวที่เดินคือดีเลย์ที่สะสม และยิ่งข้อมูลเป็นแบบ "เฉพาะบุคคล" (personalized) ซึ่งต้องดึงข้อมูลต่างกันไปในแต่ละ request ยิ่งเห็นความต่างชัดเจนขึ้นไปอีก
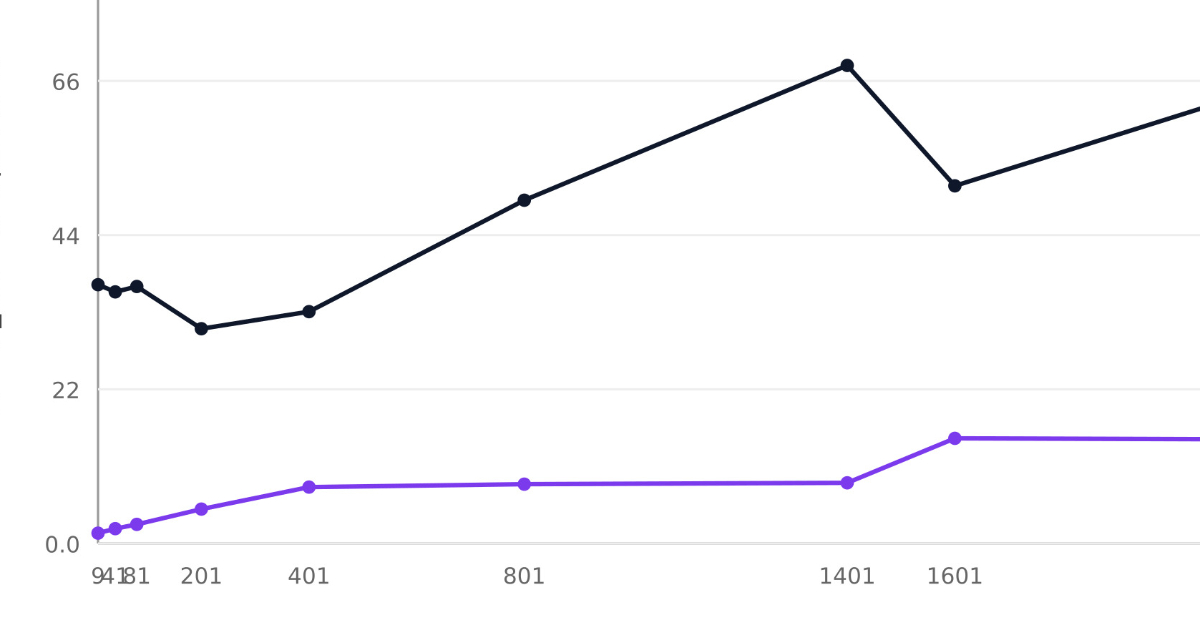
สิ่งที่แฮร์เปอร์นำเสนอคือแนวคิด "single-runtime" — เก็บโค้ดและข้อมูลไว้ในที่เดียวกัน ไม่ต้องวิ่งข้าม network ให้เสียเวลา ผลลัพธ์จากเบนช์มาร์กของเค้าบอกว่า ทำงานบน workload แบบ live และ personalized ได้ดีกว่าสแตกเวอร์เซลอย่างมีนัยสำคัญ ตัวเลขนี้ถ้าใครยังสงสัยก็ไปไล่ดูรายละเอียดได้ แต่ประเด็นคือทิศทางมันชัดเจน
ต้นตอของแนวคิดนี้ไม่ใช่เรื่องใหม่ในเชิงทฤษฎี — เข้าใจง่ายๆ ว่า "ข้อมูลอยู่ใกล้โค้ดที่สุด = เร็วที่สุด" แต่สิ่งที่ทำให้รอบนี้ต่างคือการทำให้มันใช้ได้จริงในระดับโปรดักชัน แฮร์เปอร์ไม่ได้แค่พูดถึงคอนเซปต์ แต่ปล่อยเวอร์ชัน 5.2 ออกมาพร้อมของใหม่ที่จับต้องได้ นั่นคือ "record cache" และปริมาณงานต่อโหนดที่เพิ่มขึ้น (more throughput per node)
ของใหม่อย่าง record cache ในเวอร์ชัน 5.2 คือการเร่งความเร็วอีกระดับสำหรับการอ่านข้อมูลที่เรียกใช้บ่อยๆ มันลดภาระการคำนวณซ้ำแล้วซ้ำเล่า และเมื่อรวมกับ throughput ต่อโหนดที่เพิ่มขึ้น หมายความว่าเครื่องเดิมๆ จำนวนเท่าเดิม แต่รับงานได้มากขึ้น — ต้นทุนต่อ request ลดลง นี่คือสิ่งที่ทีม infra ชอบใจแน่นอน
ต้องบอกตรงๆ ว่าผมไม่ได้เห็นด้วยกับทุกอย่างที่แฮร์เปอร์พูด 100% เพราะการย้ายทุกอย่างมารวมกันก็มีข้อแลกเปลี่ยนเรื่องการสเกลแนวนอน (horizontal scaling) ที่ทำได้ยากกว่า แต่ในกรณี workload ที่เป็น "real-time personalized" จริงๆ การลด latency ลงได้ขนาดนี้เป็นเรื่องที่ไม่มีใครปฏิเสธได้ และนี่คือจุดที่สแตกแบบดั้งเดิมกำลังอ่อนแอที่สุด
ถ้าถามผม — ข่าวนี้ไม่ใช่แค่ข่าวโปรดักต์รีลีส แต่คือสัญญาณว่า "ยุคของการประกอบระบบจากชิ้นส่วนหลายๆ ตัวโดยไม่คิดหน้าคิดหลัง" กำลังถูกท้าทาย วงการ dev เริ่มตั้งคำถามกับ complexity ที่เราสร้างขึ้นเอง และอยากได้ของที่ "มันทำงานได้เลย" มากกว่าเดิม
สรุปสั้นแบบไม่เลี่ยง — แฮร์เปอร์กำลังชี้ว่า "ยิ่งแยกยิ่งช้า" และ 5.2 คือหมัดแรกที่ทำให้คนต้องหันมามองสถาปัตยกรรมแบบรวมศูนย์อย่างจริงจัง ใครที่กำลังเจ็บกับปัญหา latency บนข้อมูลเฉพาะบุคคล ลองเปิดใจดูได้ ไม่เสียหาย
ที่มา: InfoQ AI/ML — อ่านต้นฉบับ
ความคิดเห็น 4
กำลังโหลดความคิดเห็น...