


















เจาะประเด็น
Local LLM
Qwen3.8 27B บวกเลขในหัวได้ 167 จาก 169 ข้อ บนเครื่องตัวเอง ไม่ต้องพึ่งคลาวด์
การทดลองสองปีก่อนถูกหยิบมารันใหม่บนฮาร์ดแวร์ในบ้าน แล้วผลลัพธ์ก็บอกอะไรบางอย่างเกี่ยวกับโมเดลขนาดกลางที่หลายคนมองข้าม
ทีมข่าว เอไอไทย.com
⏱ อ่าน 4 นาที
คำถามไม่ได้อยู่ที่ว่าโมเดลบวกเลขเก่งแค่ไหน แต่อยู่ที่ว่าเราไว้ใจ "กระบวนการคิด" ของมันได้จริงหรือเปล่า
เรื่องนี้เริ่มจากโพสต์ของ Colin Frasier บน Bluesky เมื่อสองปีก่อน เขาลองให้ GPT-4o ทำอะไรง่ายๆ ที่คนมักคิดว่าโมเดลทำได้สบาย นั่นคือ "บวกเลขให้ถูก แล้วตอบออกมาเป็นตัวอักษร" ไล่ไปเรื่อยๆ ตั้งแต่เลขน้อยไปจนถึงเลขใหญ่มากๆ แล้วเอาผลมา plot เป็น heatmap ให้ดูกันชัดๆ
Simon Willison บอกไว้ตรงๆ ว่าเขาเชื่อว่า GPT-4o ไม่ได้โกงด้วยการแอบเรียกเครื่องคิดเลข เพราะมันบวกผิดเยอะเหลือเกิน — ซึ่งจริงๆ แล้วนี่คือจุดที่น่าสนใจที่สุดของเรื่อง เพราะมันยืนยันว่าโมเดลกำลัง "คำนวณในหัว" จริงๆ ไม่ใช่ดึงคำตอบจากเครื่องมือภายนอก
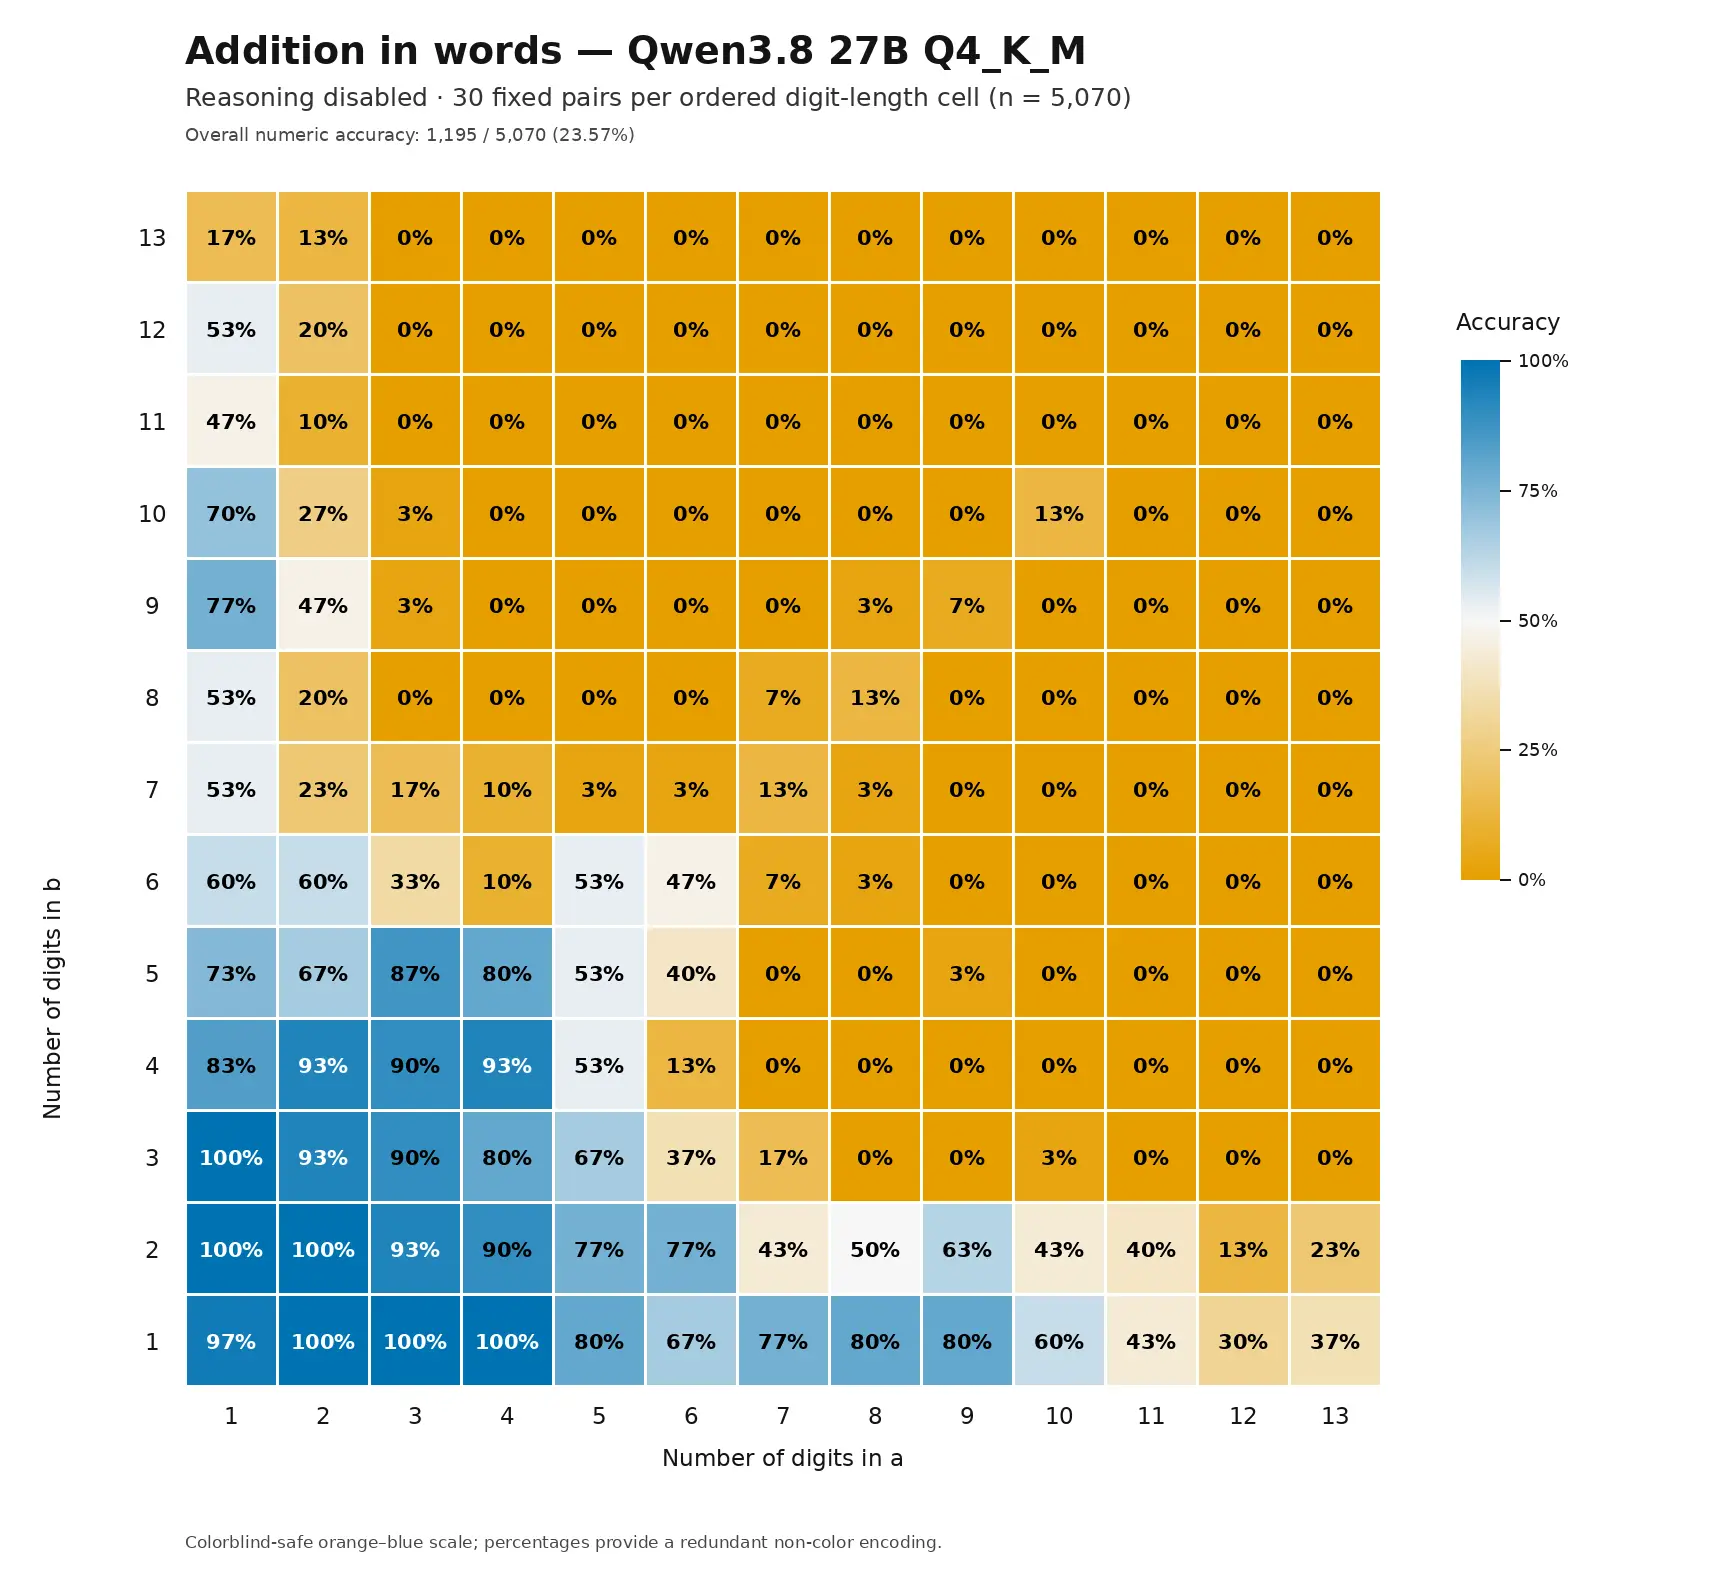
Willison เลยเอาภาพของ Frasier ไปแปะใน Codex Remote session ที่รันบน GPT-6 Astra แล้วสั่งให้ทำการทดลองเดิม แต่เปลี่ยนมาใช้ Qwen3.8-27B-Q4_K_M.gguf บนเครื่องของตัวเอง — เป็น DGX Spark ซึ่งเป็นฮาร์ดแวร์ในบ้าน ไม่ใช่คลาวด์
รอบแรกเขารัน 30 ครั้งต่อหนึ่งชุดตัวเลข โดยปิด reasoning ไว้ ผลออกมาเป็น heatmap ที่ดูสวยงามตามสไตล์ เพราะมี gradation ของความสำเร็จให้เห็น
รอบสองเขาเปิด reasoning ปรากฏว่าใช้เวลานานขึ้นมากต่อหนึ่งคู่ตัวเลข เขาเลยตัดสินใจรันแค่ครั้งเดียวต่อหนึ่งช่อง แทนที่จะรัน 30 ครั้ง ผลลัพธ์ที่ได้คือ heatmap ที่หน้าตาไม่ค่อยสวย เพราะแต่ละช่องเป็นได้แค่ 100% หรือ 0% เท่านั้น
ตัวเลข 167 จาก 169 ครั้งที่ตอบถูกนี่คือประเด็นสำคัญ เพราะมันคือ one-shot คือถามครั้งเดียวจบ ไม่มีการ retry ไม่มีการเลือกคำตอบที่ดีที่สุดจากหลายรอบ ซึ่งถ้าใครเคยเล่น local LLM มาก่อนจะรู้ว่าตัวเลขนี้ไม่ได้ธรรมดาเลย
Willison แนบ report ที่มี reasoning trace ของการคำนวณเลขใหญ่ๆ มาด้วย ซึ่งจะเห็นว่าโมเดลเขียนกระบวนการคิดออกมาเป็นขั้นตอนจริงๆ ตัวอย่างเช่นตอนที่มันต้องบวก 4,299,366,105,622 กับ 6,088,794,067,970
มันเขียนว่า "Wait, let me redo this more carefully" แล้วจัดเรียงตัวเลขทั้งสองให้ตรงหลัก จากนั้นบวกจากขวาไปซ้ายทีละหลัก หลักหน่วย 2+0=2 หลักสิบ 2+7=9 หลักร้อย 6+9=15 เขียน 5 ทด 1 ไปเรื่อยๆ
นี่คือสิ่งที่คนเรียกว่า chain-of-thought จริงๆ ไม่ใช่แค่การเดาคำตอบแล้วเขียนคำอธิบายทีหลัง แต่เป็นการที่โมเดลสร้างกระบวนการคิดแบบ step-by-step ขึ้นมาจริงๆ แล้วเดินตามกระบวนการนั้น
ที่น่าสนใจคือคำว่า "Wait, let me redo this more carefully" — มันคือการที่โมเดลรู้ตัวว่ากำลังจะพลาด แล้วหยุดตัวเองก่อนที่จะให้คำตอบผิด ซึ่งเป็นพฤติกรรมที่เกิดขึ้นได้ยากมากในโมเดลขนาดเล็กหรือโมเดลที่ไม่ผ่านการฝึก reasoning มาเป็นอย่างดี
ขนาดโมเดลไม่ใช่ทุกอย่าง
Qwen3.8 27B เป็นโมเดลขนาดกลาง ไม่ใช่โมเดลยักษ์ แต่ทำคะแนนได้ 167/169 ในการทดสอบ one-shot
Quantization ไม่ได้ฆ่าความสามารถ
เวอร์ชัน Q4_K_M เป็นการบีบอัดที่ลดขนาดลงพอสมควร แต่ยังรักษาความแม่นยำในการคำนวณไว้ได้
รันบนเครื่องตัวเองได้จริง
DGX Spark คือฮาร์ดแวร์สำหรับงาน AI ในระดับ desktop ไม่ต้องเช่าคลาวด์ ไม่ต้องส่งข้อมูลออกไปนอกบ้าน
ประเด็นไม่ได้อยู่ที่ว่า Qwen3.8 27B เก่งกว่า GPT-4o หรือเปล่า แต่อยู่ที่ว่าโมเดลขนาดกลางที่รันบนเครื่องตัวเองได้ ผ่านการ quantize แล้ว ยังสามารถ "คิดเป็นขั้นตอน" และตรวจสอบตัวเองได้ในระดับนี้ นี่คือสัญญาณว่า local LLM กำลังเข้าสู่ช่วงที่ใช้งานจริงจังได้แล้ว ไม่ใช่ของเล่นสำหรับสาย geek อีกต่อไป
ที่มา: Simon Willison's Weblog — อ่านต้นฉบับ
ความคิดเห็น 4
กำลังโหลดความคิดเห็น...