


















อัปเดต
AI / Tools
กูเกิลเปิด Gemini Live คุยเสียงสองทางแบบขัดจังหวะได้ ของเล่นใหม่ที่สาย dev ต้องลอง
สองโมเดลเสียงใหม่จากกูเกิล กับหน้าเว็บทดลองที่เขียนไม่กี่บรรทัดก็คุยกับ AI ได้แล้ว
ทีมข่าว เอไอไทย.com
⏱ อ่าน 3 นาที
เรื่องนี้ไม่ได้อยู่ที่โมเดลใหม่อย่างเดียว แต่อยู่ที่คนนอกบ้านอย่างเราลองของได้เร็วแค่ไหนต่างหาก
กูเกิลปล่อย Gemini 3.8 Live กับ 3.8 Live Extended Thinking ออกมาเมื่อวานนี้ สองโมเดลนี้เป็นสาย speech-to-speech คือคุยเสียงเข้าเสียงออกโดยตรง ไม่ต้องผ่านการแปลงเป็นข้อความก่อน แล้วค่อยแปลงกลับเป็นเสียงแบบที่เราเห็นกันบ่อยๆ ในยุคก่อน โครงสร้างมันคล้ายกับตระกูล GPT-Live ของ OpenAI เป๊ะ คือจัดทรงมาชนกันตรงๆ ในตลาดโมเดลเสียงสองทาง
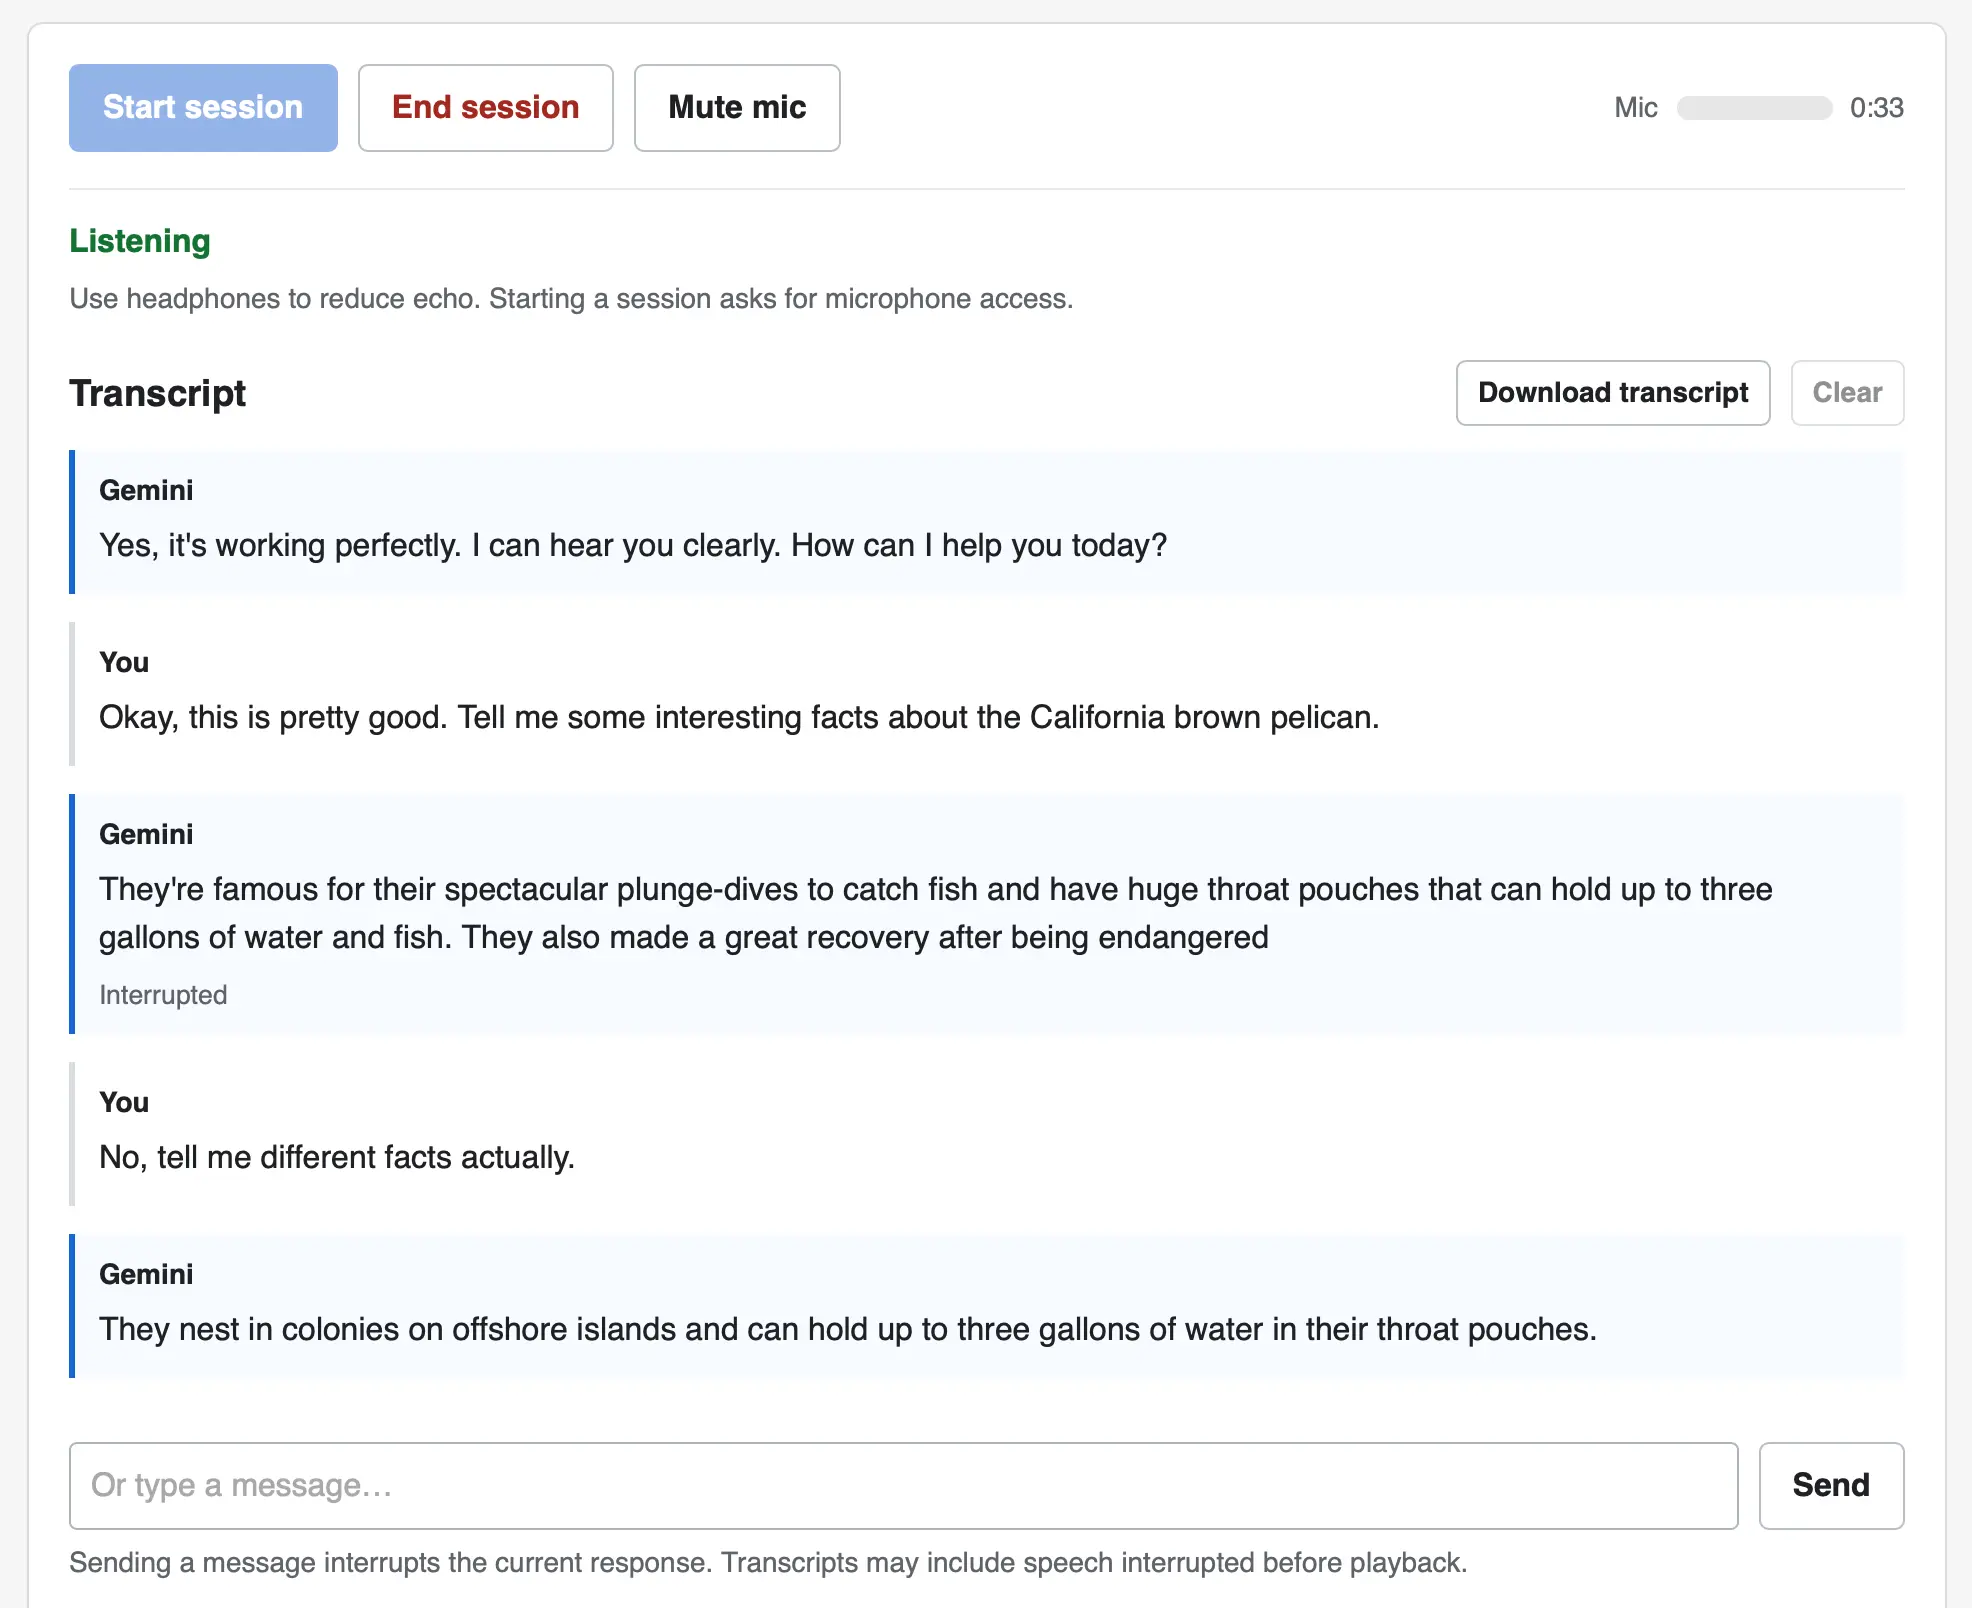
จุดที่น่าสนใจกว่าตัวโมเดลคือ Simon Willison นักพัฒนาและบล็อกเกอร์สาย AI เอาตัว GPT-6 Astra Extra High มาช่วยอ่านเอกสารของกูเกิล แล้วสั่งให้เขียนหน้าเว็บ UI ขึ้นมาตัวนึงสำหรับลองโมเดลใหม่นี้โดยเฉพาะ หน้าตาก็เรียบง่าย เลือกโมเดล เลือก preset เสียง พิมพ์ system prompt ถ้าอยากใส่ แล้วกดเริ่มคุยกับ AI ผ่านเบราว์เซอร์ได้เลย
ไฮไลต์ที่ทำให้ผมอยากเขียนถึงข่าวนี้ไม่ใช่ความสามารถของโมเดล แต่คือความเรียบง่ายของโค้ดที่ Simon เขียน มันไม่ใช้ไลบรารีอะไรเลยสักตัว ไม่มี SDK ห่อ ไม่มีเฟรมเวิร์ก ไม่มีอะไรทั้งนั้น ต่อตรงเข้า WebSocket endpoint ของกูเกิลที่ wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=... แล้วใช้ Web Audio API AudioContext จัดการทั้งการอัดเสียงและเล่นเสียงกลับ
ที่เจ๋งคือมันรองรับการขัดจังหวะโมเดลตอนกำลังพูดได้ด้วย อันนี้คือสิ่งที่ทำให้การคุยกับ AI เสียงรู้สึกเป็นธรรมชาติขึ้นเยอะ ไม่ต้องรอให้มันพูดจบก่อนแล้วค่อยแทรก เหมือนคุยกับคนจริงๆ ที่พูดแทรกได้
ลองคิดดูว่ายุคนี้การต่อ AI เข้ากับแอปมันง่ายขนาดไหนแล้ว แค่ WebSocket กับ Web Audio API สองอย่างจบ ไม่ต้องลง npm install อะไรเป็นพรวน ไม่ต้องอ่าน SDK doc ครึ่งวัน ไม่ต้องรอ community ทำ wrapper ให้ ต่อตรงไปที่ endpoint ของกูเกิลแล้วคุยได้เลย นี่คือสัญญาณว่า generative AI กำลังกลายเป็น primitive พื้นฐานของเว็บไปแล้ว ไม่ใช่ของพิเศษที่ต้องมีทีมวิศวกรคอยดูแลอีกต่อไป
อีกมุมที่คนมองข้ามคือการที่ Simon ใช้ GPT-6 Astra Extra High อ่านเอกสารให้แล้วเขียนโค้ดขึ้นมา อันนี้สะท้อน workflow ของนักพัฒนาในปีนี้ชัดมาก คือไม่ต้องนั่งอ่าน API reference เองทั้งหมดแล้ว ให้โมเดลอ่านแล้วสร้าง draft ให้ แล้วเรามา review ต่อ นี่คือวิธีทำงานที่กำลังกลายเป็นมาตรฐานใหม่ของสาย dev
สำหรับคนที่เล่น AI สาย dev อยู่แล้ว ข่าวนี้คือของเล่นใหม่ที่ต้องลอง เพราะหน้าเว็บนี้เป็นตัวอย่างโค้ดที่อ่านจบในไม่กี่นาที เอาไปดัดแปลงต่อได้ทันที อยากได้ voice assistant ในโปรเจกต์ตัวเอง หรืออยากทดลอง prompt แบบเสียง ก็เริ่มได้เลยโดยไม่ต้องพึ่งบริการ third-party
ส่วนคนที่ตามตลาดโมเดลเสียงอยู่ นี่คือการประกาศว่ากูเกิลไม่ยอมปล่อยให้ OpenAI ครองพื้นที่ speech-to-speech คนเดียว การแข่งกันปล่อยโมเดลตระกูล Live/Realtime จะยิ่งดุขึ้นเรื่อยๆ ในเดือนต่อๆ ไป และคนที่ได้ประโยชน์ที่สุดคือนักพัฒนาที่มีตัวเลือกให้ลองเยอะขึ้น
โมเดลใหม่ 2 ตัว
Gemini 3.8 Live และ 3.8 Live Extended Thinking เป็นโมเดล speech-to-speech คุยเสียงสองทางได้โดยตรง โครงสร้างคล้ายตระกูล GPT-Live ของ OpenAI
หน้าเว็บทดลองแบบไม่พึ่งไลบรารี
เลือกโมเดล เลือก preset เสียง ใส่ system prompt แล้วคุยผ่านเบราว์เซอร์ได้ รองรับการขัดจังหวะโมเดลตอนพูด ต่อตรงผ่าน WebSocket และ Web Audio API
ข่าวนี้ไม่ได้น่าตื่นเต้นเพราะกูเกิลออกโมเดลใหม่ แต่น่าตื่นเต้นเพราะมันพิสูจน์ว่าแค่ WebSocket กับ Web Audio API สองอย่าง ก็คุยกับ AI เสียงสองทางได้แล้ว ของแบบนี้เมื่อก่อนต้องรอ SDK ต้องรอทีม platform เปิดให้ ตอนนี้ต่อตรงจบ ใครยังคิดว่า AI เป็นเรื่องไกลตัว ก็คงต้องคิดใหม่
ที่มา: Simon Willison's Weblog — อ่านต้นฉบับ
ความคิดเห็น 5
กำลังโหลดความคิดเห็น...