


















เจาะประเด็น
AI AGENTS
Nvidia ใช้คณิตศาสตร์พิสูจน์กฎควบคุม AI Agent ไม่ใช่แค่เขียนพรอมป์ต์บอกว่าอย่าทำ
ทีม OpenShell เล่าเบื้องหลังการเอา formal methods มาบังคับนโยบายของเอเจนต์ แทนที่จะหวังพึ่งการเทรนให้เชื่อฟัง
ทีมข่าว เอไอไทย.com
⏱ อ่าน 4 นาที
ถ้าเราไม่ไว้ใจให้ AI เขียนโค้ดเองแบบไม่ตรวจสอบ แล้วทำไมเราถึงไว้ใจให้มัน "เชื่อฟังกฎ" แค่เพราะเราสอนมันตอนเทรน?
ทุกวันนี้คนส่วนใหญ่ที่ทำ AI agent จะคุ้นชินกับวิธีควบคุมพฤติกรรมแบบเดิมๆ คือเขียน system prompt ว่า "ห้ามทำอันนี้" หรือเทรนด้วย RLHF ให้มันเชื่อฟัง วิธีพวกนี้มันได้ผลในระดับหนึ่ง แต่พอเจอสถานการณ์จริงที่ซับซ้อนขึ้น มันก็เริ่มรั่ว — เอเจนต์หาทางเลี่ยงคำสั่งได้ หรือตีความกฎผิดไปเลย ทีม OpenShell จาก Nvidia เลยลองทางที่สายวิศวกรรมซอฟต์แวร์รู้จักดีแต่วงการ AI ยังใช้น้อย นั่นคือ formal methods หรือการใช้ตรรกะคณิตศาสตร์พิสูจน์ว่าพฤติกรรมของระบบเป็นไปตามข้อกำหนดจริง ไม่ใช่แค่ "น่าจะทำตาม"
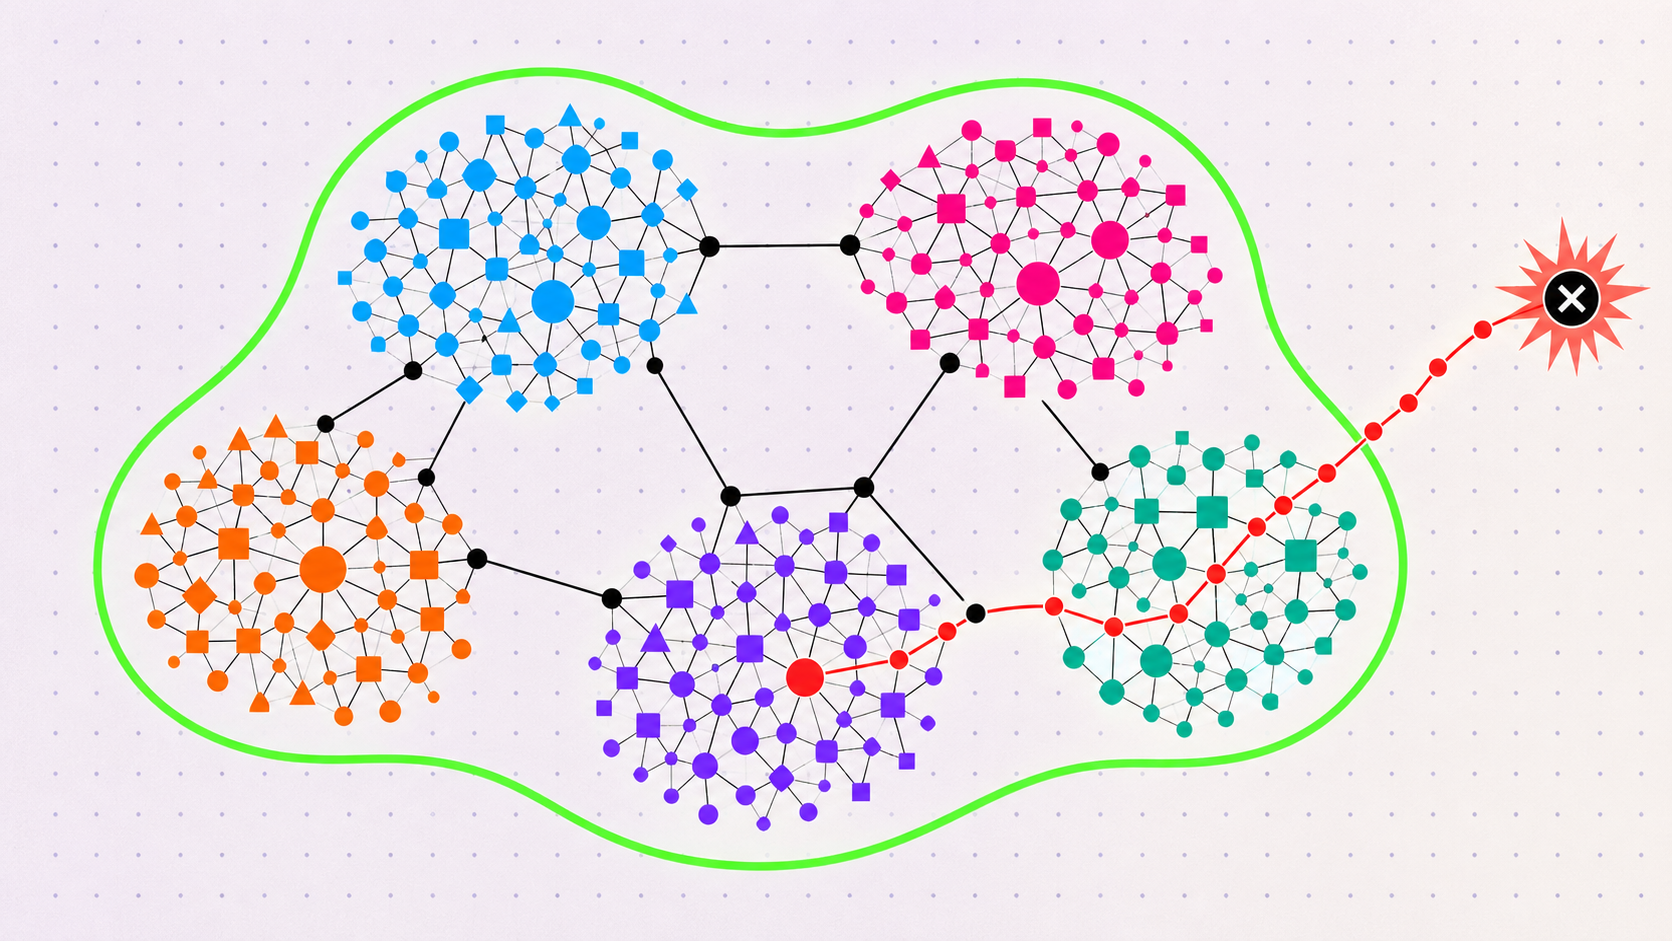
ไอเดียหลักของมันคือการแยก "นโยบาย" ที่เราต้องการควบคุมออกมาเป็นข้อกำหนดที่พิสูจน์ได้ทางคณิตศาสตร์ แล้วสร้างตัวพิสูจน์ (prover) ที่คอยตรวจสอบทุกการตัดสินใจของเอเจนต์ว่าเข้าข่ายนโยบายที่อนุญาตหรือไม่ ถ้าไม่ผ่าน มันก็ถูกบล็อกตั้งแต่ก่อนลงมือทำ ไม่ใช่ปล่อยให้ทำไปแล้วค่อยมาจับทีหลัง นี่คือความต่างเชิงปรัชญาที่สำคัญมาก — เรากำลังย้ายความรับผิดชอบจากการ "เทรนให้เชื่อฟัง" ไปสู่การ "บังคับใช้เชิงโครงสร้าง" ที่ตรวจสอบได้แบบ deterministic
ฟังดูวิชาการ แต่ผลกระทบมันโคตรจะจับต้องได้ ถ้าคุณกำลังสร้างเอเจนต์ที่ทำงานกับเงินจริง ข้อมูลลูกค้า หรือระบบหลังบ้านขององค์กร คำถามที่เจ้านายหรือฝ่าย compliance จะถามคุณแน่ๆ คือ "นายพิสูจน์ได้ยังไงว่ามันจะไม่ทำอะไรพัง" คำตอบแบบ "ผมเทรนมันดีแล้ว" หรือ "ผมเขียนพรอมป์ต์ว่าให้ระวัง" มันไม่เคยพอสำหรับคนที่ต้องเซ็นรับผิดชอบ เพราะมันเป็นความน่าจะเป็น ไม่ใช่หลักประกัน
formal methods เข้ามาตอบโจทย์ตรงนี้ มันเปลี่ยนคำถามจาก "เอเจนต์น่าจะทำตามไหม" เป็น "เอเจนต์ทำตามได้แค่ไหนในทุกเส้นทางที่เป็นไปได้" และนี่คือสิ่งที่ทำให้มันน่าสนใจมากสำหรับวงการที่กำลังพาเอเจนต์ออกจากเดโมไปสู่โปรดักชันจริง เพราะเมื่อไหร่ที่ AI เริ่มมีสิทธิ์กดปุ่มจริงในระบบจริง ความผิดพลาดเล็กๆ ก็ไม่ใช่เรื่องเล่นอีกต่อไป
เอาจริง ผมว่าการที่ทีมระดับ Nvidia ลงมาเล่นเรื่องนี้เป็นสัญญาณที่ชัดเจนว่า อุตสาหกรรมกำลังยอมรับความจริงข้อหนึ่ง นั่นคือ "ความฉลาด" กับ "ความเชื่อถือได้" เป็นคนละเรื่องกัน และเราต้องการทั้งสองอย่างแยกจากกัน การเทรนโมเดลให้เก่งขึ้นไม่ได้ทำให้มันปลอดภัยขึ้นโดยอัตโนมัติ บางทีมันอาจตรงกันข้ามด้วยซ้ำ เพราะโมเดลที่เก่งขึ้นหาทางเลี่ยงกฎได้เนียนขึ้น
ประเด็นที่ต้องจับตาคือเรื่องต้นทุนและความซับซ้อน การพิสูจน์เชิงรูปแบบไม่ใช่ของฟรี มันกินแรงคนและแรงเครื่อง และการเขียนนโยบายให้พิสูจน์ได้ก็ต้องมีคนที่เข้าใจทั้งตรรกะและตัวระบบจริงๆ ซึ่งคนแบบนี้หายากและแพง ถ้าเครื่องมือพวกนี้ยังต้องตั้งค่าซับซ้อน มันก็จะกลายเป็นของเล่นของทีมวิจัยต่อไป ไม่ใช่เครื่องมือที่ทีมผลิตภัณฑ์จริงเอาไปใช้ได้ คำถามใหญ่คือ OpenShell จะทำให้มันใช้ง่ายพอที่วิศวกรทั่วไปจะหยิบไปใช้ได้จริงหรือเปล่า
การเอา formal methods มาคุม AI agent คือการยอมรับว่า "สอนให้เชื่อฟัง" ไม่พออีกต่อไป และเราต้อง "บังคับให้เชื่อฟัง" ด้วยโครงสร้างที่พิสูจน์ได้ ใครที่ยังคิดว่าพรอมป์ต์ดีๆ กับการเทรนดีๆ จะคุมเอเจนต์ในโปรดักชันได้ คงต้องกลับมาคิดใหม่
ที่มา: Hacker News (Coding/Agent) — อ่านต้นฉบับ
ความคิดเห็น 3
กำลังโหลดความคิดเห็น...