


















เจาะประเด็น
AI / DevTools
Akka เอาของจริง 65 โปรเจกต์มาทดสอบ AI เขียนโค้ด แล้วเจอคำตอบที่หลายคนไม่อยากได้ยิน
สเปกดี ไม่ได้แปลว่าโมเดลจะทำได้ดีเท่ากันทุกตัว และนี่คือหลักฐานจากของจริง ไม่ใช่ความเชื่อในเดโม
ทีมข่าว เอไอไทย.com
⏱ อ่าน 3 นาที
ถ้าคุณยังเชื่อว่า "เขียนสเปกให้ดีแล้ว AI จะทำได้หมด" งานทดลองนี้คือของจริงที่ควรอ่านก่อนตัดสินใจ
เรื่องนี้ไม่ใช่ข่าวเปิดตัวโมเดลใหม่ ไม่ใช่ข่าวระดมทุนร้อยล้าน แต่เป็นข่าวที่คนทำงานสายพัฒนาซอฟต์แวร์ควรอ่านให้จบ เพราะ Akka เอาของจริง 65 โปรเจกต์โอเพนซอร์สมาทดลองว่า "ถ้าให้ AI ช่วยพอร์ตโค้ด" ตัวแปรอะไรบ้างที่ทำให้ผลลัพธ์ดีหรือแย่ และคำตอบที่ได้ก็ไม่ใช่คำตอบสวยหรูแบบที่ผู้ขายเครื่องมือ AI ชอบโปรโมต
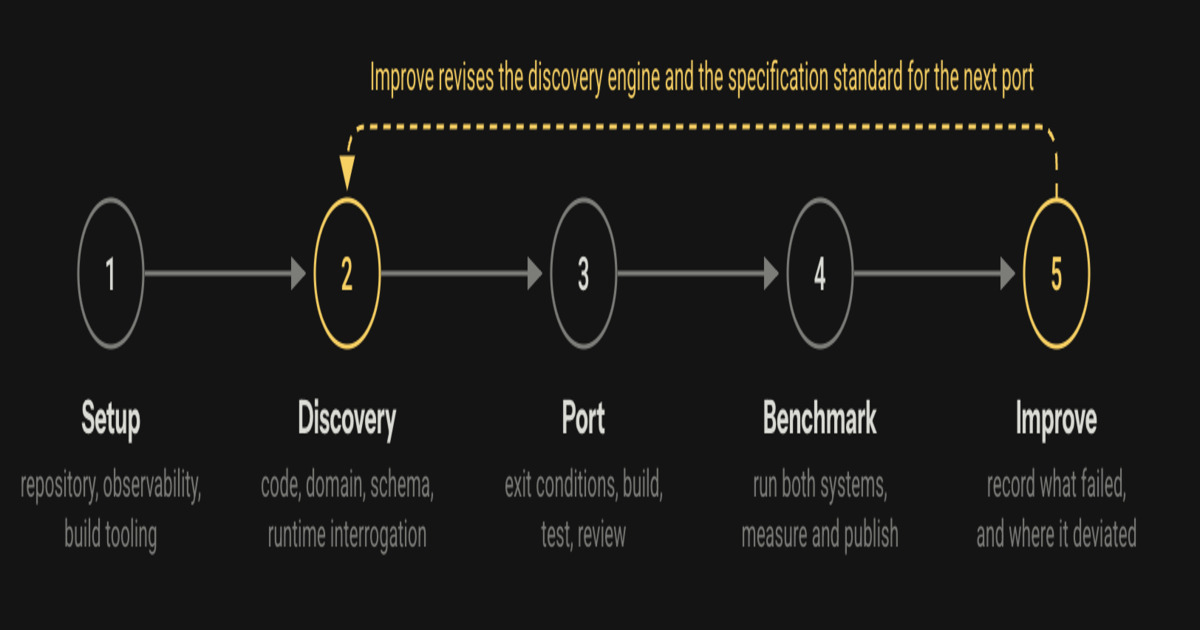
ตัวการทดลองของ Akka ไม่ได้วัดแค่ "AI เขียนโค้ดผ่านไหม" แต่ซอยออกเป็นหลายแกนพร้อมกัน ตั้งแต่โครงสร้างของสเปก (spec structure) ที่ป้อนให้โมเดล, บริบทที่แนบไป (context), การเลือกโมเดล (model selection), ระบบตรวจสอบอัตโนมัติ (automated validation) ไปจนถึง guardrail ของกระบวนการส่งมอบงาน นี่คือการมอง AI เขียนโค้ดแบบเป็นระบบวิศวกรรม ไม่ใช่แค่กดปุ่มแล้วรอดูผล
สิ่งที่เขาวัดก็ไม่ได้เล่นๆ นะ มีทั้งเวลาที่ใช้จริง ปริมาณโทเคนที่เผาไป ขนาดโค้ดที่ได้ออกมา ความเท่าเทียมของเทสต์ (test parity) และประสิทธิภาพของโค้ดหลังพอร์ตเสร็จ ห้าตัวชี้วัดนี้สำคัญมาก เพราะมันบอกว่า "AI ทำงานเสร็จ" กับ "AI ทำงานได้ดี" คนละเรื่องกัน และหลายทีมในอุตสาหกรรมนี้ก็ยังแยกสองอย่างนี้ไม่ออก
ผลลัพธ์ที่ออกมาคือ "substantial variation" หรือพูดแบบบ้านๆ ก็คือ ผลลัพธ์แกว่งหนักมาก แตกต่างกันอย่างมีนัยสำคัญทั้งระหว่างโมเดล ระหว่างระดับความพยายาม (effort levels) ที่ตั้งไว้ และระหว่างประเภทของโปรเจกต์ นี่คือประเด็นที่คนทำงานจริงต้องสนใจ เพราะมันแปลว่า "โมเดลที่เทพสุด" ไม่ได้ชนะทุกสนาม และ "ตั้ง effort สูงสุด" ก็ไม่ได้การันตีผลลัพธ์ที่ดีที่สุดเสมอไป
จุดที่น่าสนใจคือ Akka ไม่ได้บอกว่า "AI ทำได้" หรือ "AI ทำไม่ได้" แบบขาวดำ แต่บอกว่า "ขึ้นอยู่กับ" ซึ่งเป็นคำตอบที่จริงที่สุดในเวลานี้ แต่ก็เป็นคำตอบที่คนขายเครื่องมือ AI ไม่อยากพูดออกไมค์ เพราะมันขัดกับ narrative ที่ว่า "แค่ซื้อเครื่องมือเรา ทีมคุณก็เขียนโค้ดเร็วขึ้น 10 เท่า"
การทดลองนี้ยังตอกย้ำอีกเรื่องที่หลายคนเริ่มรู้ตัวแล้ว คือ spec-driven development ไม่ใช่ยาครอบจักรวาล การเขียนสเปกให้ดีเป็นเงื่อนไขจำเป็น แต่ไม่ใช่เงื่อนไขพอเพียง เพราะยังมีตัวแปรอื่นอีกเพียบ ทั้งการเลือกโมเดลให้เหมาะกับงาน, การให้บริบทที่ถูกจุด, การตั้ง guardrail ที่ไม่รัดจนงานไม่เดิน และการตรวจสอบอัตโนมัติที่จับปัญหาก่อนที่มันจะหลุดไปถึงโปรดักชัน
สำหรับทีมไทยที่กำลังลองเอา AI มาช่วยงานพอร์ตโค้ดหรือ migrate legacy system งานทดลองนี้คือสัญญาณเตือนว่า อย่าเหมารวมว่า "โมเดล X เก่ง" แล้วใช้กับทุกโปรเจกต์ เพราะผลลัพธ์มันขึ้นกับบริบทของโปรเจกต์นั้นๆ ด้วย การวัดผลแบบเป็นระบบอย่างที่ Akka ทำ คือสิ่งที่ทีมควรลอกเลียนแบบ ไม่ใช่เชื่อรีวิวหรือ benchmark ทั่วไปที่ไม่ได้มาจากโค้ดเบสของตัวเอง
อีกมุมที่ต้องพูดคือ 65 โปรเจกต์โอเพนซอร์สอาจไม่เท่ากับโค้ดเบสปิดในองค์กรที่มีความซับซ้อนและ dependency พันกันยุ่งกว่า แต่การที่งานวิจัยนี้เปิดให้ดูว่าวัดอะไรบ้าง ก็มีค่ามากพอให้ทีมเอาไปออกแบบการทดลองของตัวเองได้
บทเรียนจากงานนี้ไม่ใช่ "AI เก่งหรือห่วย" แต่คือ "AI เก่งไม่เท่ากันในทุกงาน" ใครที่ยังเชื่อว่าเขียนสเปกดีแล้วจบ ควรกลับไปดูผลลัพธ์จริงของทีมตัวเองก่อน ว่าแกว่งแค่ไหนระหว่างโปรเจกต์ — เพราะคำตอบที่ Akka เจอ อาจเป็นคำตอบเดียวกับที่ทีมคุณกำลังเจออยู่ก็ได้
ที่มา: InfoQ AI/ML — อ่านต้นฉบับ
ความคิดเห็น 3
กำลังโหลดความคิดเห็น...