


















เจาะประเด็น
AI / Engineering
Prompt อย่างเดียวไม่พอ ถึงเวลาที่ทีม AI ต้องหันมาใส่ใจ "Context Engineering" จริงๆ จังๆ
การสร้าง AI ระดับโปรดักชันไม่ใช่แค่การเขียน prompt ให้ฉลาด แต่คือการออกแบบระบบจัดการความทรงจำและบริบทให้อยู่รอดในโลกจริง
ทีมข่าว เอไอไทย.com
⏱ อ่าน 4 นาที
ถ้าคุณยังคิดว่า "prompt ดี = AI เก่ง" ขอบอกตรงนี้เลยว่าโปรเจกต์ของคุณจะพังตอนที่ต้อง scale ขึ้น production
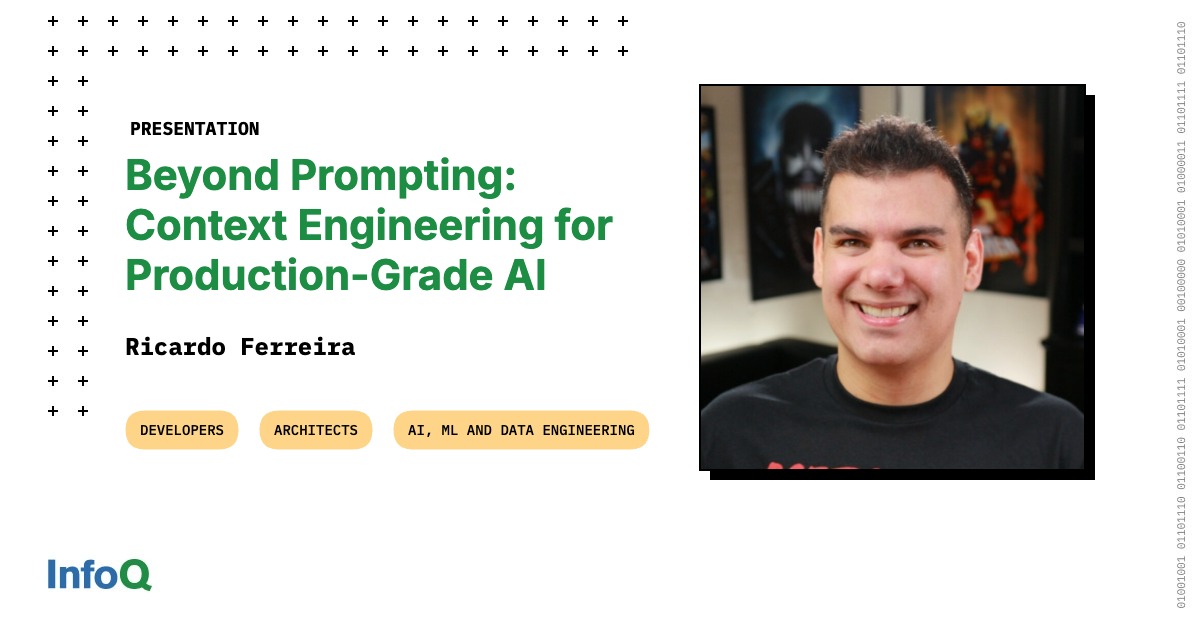
เพื่อให้เข้าใจตรงกันก่อน ใครที่ยังเมากันอยู่กับคำว่า prompt engineering นี่คือบทส่งท้ายที่ควรอ่านให้จบ เพราะ Ricardo Ferreira วิศวกรชื่อดังจาก Redis เอาเรื่องนี้มาแฉบนเวที InfoQ ว่าการจะสร้าง AI ที่ใช้งานได้จริง เงินลงทุนมหาศาล และไม่พังกลางทาง มันไม่ได้จบแค่การหาวลีวิเศษไปยิงใส่ LLM แต่มันคือการออกแบบสถาปัตยกรรมทั้งระบบให้จัดการ "บริบท" หรือ context ได้อย่างชาญฉลาดต่างหาก
พูดง่ายๆ คือตอนนี้เราผ่านยุคที่คนคิดว่า "prompt วิเศษ" จะแก้ทุกปัญหาไปแล้ว เพราะความเป็นจริงโหดร้ายกว่าเยอะ โมเดลภาษามันไม่ได้ฉลาดขนาดจำทุกอย่างที่คุณเคยคุยด้วยได้ตลอดกาล มันมีหน่วยความจำจำกัด มีค่าใช้จ่ายที่พุ่งปรี๊ดเมื่อ token เยอะขึ้น และที่สำคัญ มันดึงข้อมูลเก่าที่ไม่เกี่ยวข้องมาปนจนทำให้ผลลัพธ์เพี้ยนได้ง่ายๆ เหมือนเพื่อนที่ความจำสั้น แต่ดื้อดึงจะเล่าเรื่องเดิมซ้ำๆ ที่ไม่เข้ากับสถานการณ์
Ferreira ชี้ให้เห็นจุดอ่อนคลาสสิกที่ใครทำ AI คุยกับผู้ใช้แล้วต้องเจอ คือการที่โมเดลคุยกับคุณได้เก่งเฉพาะตอนเปิดเซสชันแรกๆ พอคุณคุยยาวไป มันเริ่มลืมว่าตอนแรกเราพูดเรื่องอะไรกัน หรือไม่ก็เริ่มมั่วเอาข้อมูลเมื่อวานมาปนกับวันนี้จนเละเทะ นี่คือเหตุผลว่าทำไมการฝากความหวังไว้กับ "context window" ที่ใหญ่ขึ้นเรื่อยๆ อย่างเดียวไม่ใช่ทางรอด เพราะยิ่งใส่ข้อมูลเข้าไปมากเท่าไหร่ ค่าใช้จ่ายยิ่งบาน ค่าหน่วงเวลา (latency) ยิ่งสูง จนวันหนึ่งคุณจะเจอบิลค่า API ที่ทำให้ผู้บริหารแทบช็อก
ประเด็นสำคัญคือมันไม่ใช่แค่เรื่องเทคนิค แต่เป็นเรื่องเงินและประสบการณ์ผู้ใช้ด้วย การที่คุณยัดประวัติการสนทนาทั้งหมดลงไปในทุกๆ คำถามที่ส่งไปหา GPT-4 หรือ Claude มันเหมือนคุณจ้างผู้เชี่ยวชาญระดับโลกมาอ่านหนังสือทั้งเล่มทุกครั้งที่คุณถามว่า "ตอนนี้กี่โมงแล้ว" ทั้งแพงทั้งช้า แล้วผลลัพธ์ที่ได้ก็ไม่ได้ดีขึ้นเลยแม้แต่นิดเดียว
ทางออกที่ Ferreira เสนอไม่ใช่เรื่องเวทมนตร์ แต่มันคือวิศวกรรมที่แท้จริง นั่นคือการแยก "ความทรงจำ" ออกเป็นสองแบบ แบบสั้น (short-term) ที่ใช้เก็บบทสนทนาล่าสุดในเซสชันเดียว และแบบยาว (long-term) ที่ฝังอยู่ในฐานข้อมูลอย่าง Redis เพื่อให้ AI ดึงความรู้เดิมกลับมาใช้ได้เมื่อจำเป็น แทนที่จะต้องส่งประวัติทั้งหมดไปให้โมเดลทุกครั้ง
นอกจากนี้ยังมีเทคนิคจัดการ token ที่ชาญฉลาดขึ้น เช่น การสรุปความ (summarization) เพื่อย่อบทสนทนาที่ยาวเป็นชิ้นเล็กๆ ก่อนส่งเข้าโมเดล แทนที่จะส่งฉบับเต็ม รวมถึงการใช้เทคนิค "reranking" เพื่อกรองเอาข้อมูลที่เกี่ยวข้องจริงๆ ออกจากคลังความรู้ขนาดใหญ่ ก่อนที่จะเอาไปใส่ใน prompt เพื่อลดความเสี่ยงที่เรียกว่า "context rot" หรืออาการที่ข้อมูลที่ไม่เกี่ยวข้องเข้าไปปนแล้วทำให้ AI ฟังเพี้ยน
อีกหนึ่งไอเดียที่ผมว่าคนดูถูกกันเยอะคือการใช้ "semantic caching" หรือการแคชผลลัพธ์ด้วยความหมาย ไม่ใช่แค่คำต่อคำ สมมติว่ามีคนถามว่า "ราคาหุ้นวันนี้เท่าไหร่" กับ "หุ้นตอนนี้ราคาเท่าไหร่" ความหมายมันคือคำถามเดียวกัน AI ไม่จำเป็นต้องไปคำนวณหรือเรียก API ใหม่ให้เปลืองเงิน แค่ดึงคำตอบเดิมที่แคชไว้มาใช้ก็พอ นี่คือการลดต้นทุนที่ชาญฉลาดและมองข้ามไม่ได้เลยในยุคที่ค่า token ยังแพง
Short-term Memory
เก็บเฉพาะบทสนทนาล่าสุดในเซสชัน เพื่อให้ AI ตอบโต้ได้ลื่นไหลโดยไม่ต้องส่งประวัติยาวๆ ทั้งหมดไปทุกครั้ง
Long-term Memory
ฝังความรู้เดิมลงใน Redis ดึงกลับมาใช้ได้เมื่อเจอบริบทที่เกี่ยวข้อง ประหยัดทั้งค่าใช้จ่ายและเพิ่มความแม่นยำ
Summarization & Reranking
ย่อบทสนทนาที่ยาวให้สั้นลง และกรองข้อมูลที่เกี่ยวข้องจริงๆ ก่อนส่งเข้าโมเดล เพื่อลด "context rot" และเพิ่มคุณภาพคำตอบ
สิ่งที่ Ferreira สื่อออกมาชัดเจนมากคือแนวคิดแบบ "production-grade" มันไม่ใช่ของเล่นในโน้ตบุ๊กอีกต่อไปแล้ว ถ้าคุณจะทำแชทบอทไว้โชว์เพื่อนในงานแฮกกาธอนก็ไม่ต้องซีเรียสอะไร แต่ถ้าจะทำระบบที่ต้องรองรับผู้ใช้จริงเป็นล้านคน มีเงื่อนไขเรื่องความเร็วและต้นทุน เรื่องพวกนี้คือเส้นแบ่งระหว่างโปรเจกต์ที่ตายในเดโม่ กับโปรเจกต์ที่ทำเงินจริง
ต้องยอมรับว่าบทเรียนนี้มาจากประสบการณ์จริงของทีม Redis ที่ต้องจูนระบบให้รองรับ LLM ในสเกลใหญ่ แต่มันก็ไม่ได้แปลว่าคุณต้องใช้ Redis เท่านั้นนะ สมองของเรื่องนี้คือ "แนวคิด" มากกว่าตัวเครื่องมือ การแยกความทรงจำ การจัดการ token อย่างมีสติ และการลงทุนกับ caching คือหลักการที่ใช้ได้กับทุกแพลตฟอร์ม
ถึงตรงนี้ผมว่าใครที่กำลังออกแบบระบบ AI อยู่ควรหยุดคิดเรื่อง "จะเขียน prompt ยังไงให้ได้คำตอบสวย" แล้วหันมาคิดเรื่อง "จะออกแบบระบบให้โมเดลมันจำได้ยังไงโดยไม่เจ๊ง" แทน เพราะท้ายที่สุดแล้ว ผู้ใช้ไม่ได้สนใจว่า prompt คุณโคตรจะเริ่ด พวกเขาสนใจว่าตอบถูกไหม ไม่ช้าไปไหม และคุณไม่เจ๊งก่อนที่จะได้ scale
ยุคของ "prompt วิเศษ" จบลงแล้ว ใครที่ยังเม้าท์กันอยู่แค่นั้นจะถูกทิ้งไว้ข้างหลัง เพราะของจริงมันอยู่ที่การออกแบบระบบทั้งระบบ ไม่ใช่การหาคาถาไปยิงใส่ API ให้เปลืองเงิน
ที่มา: InfoQ AI/ML — อ่านต้นฉบับ
ความคิดเห็น 6
กำลังโหลดความคิดเห็น...