


















เจาะประเด็น
Local LLMs
Qwen 3.8 27B โคตรเก่ง แต่ค่าเริ่มต้นมัน "คิดมาก" จนน่ารำคาญ
โมเดล 17GB ที่ทำได้แทบทุกอย่างบนแล็ปท็อป แต่ถ้าไม่แก้ดีฟอลต์นี่คือหายนะด้านความเร็ว
ทีมข่าว เอไอไทย.com
⏱ อ่าน 7 นาที
ถ้าโมเดลเปิดเผยขนาดนี้เก่งขนาดนี้ แล้วทำไมใครๆ ยังต้องจ่ายเงินซื้อ API แพงๆ อยู่ล่ะ?
วันศุกร์ที่ผ่านมา Alibaba ปล่อยของแรงอีกแล้ว Qwen 3.8 27B — โมเดลภาษาแบบเปิด (Apache 2) ขนาด 27B พารามิเตอร์ ความสามารถรอบด้านขนาดนี้ใส่ในไฟล์แค่ 17GB เท่านั้น ผมรอตัวนี้มานาน เพราะไซส์ 27B คือจุดหวานของคนที่อยากรันโมเดลบนแล็ปท็อปสเปกดีๆ สักเครื่อง และรุ่นก่อนหน้าอย่าง Qwen 3.6 27B ก็ทำได้ดีจนน่าประทับใจ
เบนช์มาร์กที่ Qwen รายงานเองนี่ตื่นตาตื่นใจมาก ทั้งเทียบกับรุ่นก่อนหน้าตัวเองและเทียบกับ Qwen 3.7-Plus ซึ่งเป็นโมเดลปิดที่แข็งแกร่งที่สุดตัวหนึ่งของค่ายเมื่อไม่กี่เดือนก่อน แต่แน่นอนว่าเราต้องรอดูผลทดสอบจากเบนช์มาร์กอิสระอีกที เพราะตัวเลขที่บริษัทปล่อยเองมันก็ต้องดูกันหน่อย
ผมเอาตัวนี้ไปรันบนเครื่องสองตัว: MacBook Pro M5 Max แรม 128GB กับ NVIDIA DGX Spark ทั้งคู่รันผ่าน LM Studio ด้วยไฟล์ Q4_K_M ขนาด 17GB แล้วก็ลองใช้ llama-server บน Spark ด้วย ประสบการณ์ที่ได้น่ะเหรอ? สนุกมาก แต่ไม่ใช่วิธีที่ควรใช้กับมัน
Qwen ตั้งค่า reasoning_effort ไว้ที่ "xhigh" เป็นค่าเริ่มต้น ซึ่งแปลว่ามันจะคิดให้ลึกสุดขั้วสำหรับงานที่ซับซ้อน แต่ปัญหาคือมันใช้โหมดนี้กับทุกอย่าง แม้กระทั่งงานง่อยๆ ที่ไม่ควรต้องคิดเกิน 5 วินาที มันเลยกลายเป็นคอมเมดี้โชว์ได้จริงๆ
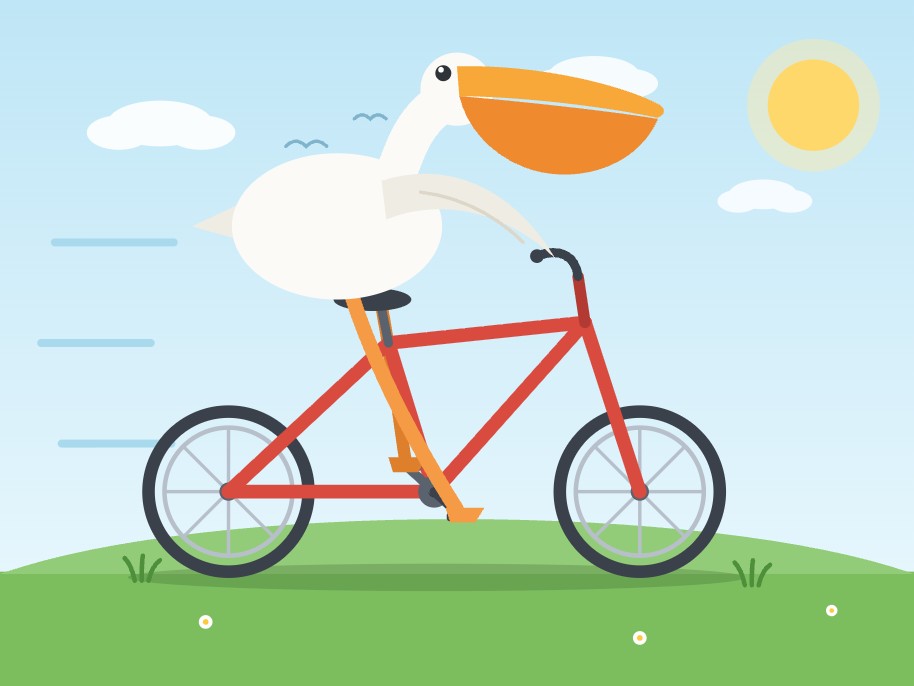
ตอนแรกผมพยายามรันด้วย context limit เริ่มต้นของ LM Studio ที่ 8,192 โทเคน แต่ Qwen กินหมดไปกับการคิดเรื่องจิ๊บจ้อย ผมเลยต้องเพิ่มเป็น 262,144 โทเคนเต็มๆ ถึงจะรอด ตัวอย่างที่เห็นชัดคือตอนให้วาด SVG นกกระทุงขี่จักรยาน — ใช้เวลาคิด 22,276 โทเคนเพื่อผลิตผลงาน 3,223 โทเคน รวมเวลา 21 นาที! ผลลัพธ์ออกมาสวยมาก โครงจักรยานถูกต้อง มีขาข้างละฝั่ง นกกระทุงชัด ปีกแตะแฮนด์ ฉากหลังมีดวงอาทิตย์ เมฆ เนินเขา ดอกไม้ — แต่ถามว่าคุ้มกับเวลารอ 21 นาทีไหม? ไม่คุ้มเอาซะเลย
ลองปิด reasoning แล้วรันพรอมต์เดียวกัน ใช้เวลาแค่ 137 วินาทีกับ 3,715 โทเคน ต่างกันราวฟ้ากับเหว ลองเทียบกับ Qwen 3.8 2.4T-A95B (รุ่นใหญ่ที่ปล่อยสัปดาห์ก่อน) ผ่าน OpenRouter ก็ได้ SVG แอนิเมชันสวยๆ แต่ก็ไม่ได้เหนือไปขนาดนั้น
ที่เด็ดสุดคือตอนสั่ง "วาด SVG วงกลม" มันคิดอยู่นานแล้วผลิตวงกลมแอนิเมชันสุดอลังการออกมา ซึ่งไม่ใช่สิ่งที่เราขอเลย มันตั้งใจทำเกินไปมาก นี่คือคำแนะนำแบบฟันธงจากผม: ลืมดีฟอลต์ไปได้เลย ใช้โหมด low หรือปิด reasoning ไปก่อน เพราะโมเดลมันดีจริง แต่ดีฟอลต์นี่คือจุดเริ่มต้นที่แย่ที่สุด
วิธีสนุกๆ ในการทดสอบ vision model คือให้มันวาดกรอบรอบวัตถุในรูป ผมลองกับรูปนกกระทุงแล้วสั่งให้คืนค่า JSON bounding box ในสเกล 0-1000 ผลที่ได้คือแม่นมาก เกือบเทียบเท่าคนทำมือเลยทีเดียว มันเข้าใจตำแหน่งและขนาดได้ถูกต้องแทบทั้งหมด
จากนั้นผมก็ให้มันสร้างเว็บแอปเล็กๆ สำหรับแสดง bounding box บนรูปภาพ ด้วยพรอมต์เดียว มันก็เขียน HTML + JavaScript ออกมาใช้งานได้จริง แถมยังใส่ฟีเจอร์ที่ผมไม่ได้ขอเพิ่มเติม เช่นปุ่มโหลดตัวอย่าง ที่มันสร้างฉากตัวอย่างเป็นนกกระทุงจำลองขึ้นมาเอง เพราะเห็นเลเบล "pelicans" ใน JSON ที่ผมส่งให้ — นี่คือความสามารถที่ทำให้ผมทั้งขำและทึ่ง
แต่ถ้าปิด reasoning แล้วให้มันทำงานเดียวกัน ผลลัพธ์ออกมาเกือบถูกแต่ไม่ถูกซะทีเดียว แสดงว่าการคิดทบทวนช่วยให้ผลลัพธ์ดีขึ้นจริง แต่ไม่จำเป็นต้องคิดมากขนาดนั้นก็ได้
คำถามใหญ่ของโมเดลท้องถิ่นคือมันแรงพอจะรัน coding agent loop ได้ไหม? Qwen 3.8 27B มีครบทั้ง context ยาว การเขียนโค้ด และ tool-calling ที่เสถียร ผมลองกับ Pi ซึ่งมี system prompt สั้นกว่าเพื่อน เหมาะกับโมเดลเล็ก และผลลัพธ์ออกมาดีเกินคาด มันสามารถอ่านไฟล์หลายๆ จุดในโปรเจกต์ ตอบคำถามเรื่องการทำงานของ auth ได้อย่างละเอียด แล้วยังเขียน Python script แปลงไฟล์ JSONL เป็น Markdown ได้สำเร็จในครั้งเดียว
สรุปคือโมเดล 17GB ตัวนี้ทำได้เกือบทุกอย่างที่เราต้องการจาก LLM ในการทำงานจริง ไม่ว่าจะเขียนโค้ด ใช้เครื่องมือ หรือประมวลผลภาพ
ที่เหลือคือความเร็ว ผมได้ประมาณ 15-30 โทเคนต่อวินาทีจาก LM Studio ซึ่งไม่แย่ แต่ก็ไม่เร็วพอที่จะดึงดูดให้เลิกใช้ API แบบโฮสต์ที่ทำได้ 74-184 โทเคนต่อวินาที แต่วงการชุมชนเริ่มหาทางเพิ่มความเร็วกันแล้ว โดยเฉพาะฟีเจอร์ Multi-Token Prediction (MTP) ที่ Qwen รองรับในตัว — เป็นเทคนิคเดาโทเคนล่วงหน้าแบบประหยัด แล้วให้โมเดลหลักตรวจสอบ ซึ่งเพิ่มประสิทธิภาพได้มาก ลองแล้วได้ความเร็วเพิ่มขึ้นถึง 72% เมื่อเทียบกับค่าเริ่มต้น
ที่จริงแล้วความที่ไฟล์ 17GB ทำอะไรได้ขนาดนี้บนเครื่องที่บ้านคือปาฏิหาริย์ เมื่อปีก่อนนี่คือระดับที่ต้องจ่ายเงินแพงๆ กับโมเดลปิด แต่ตอนนี้มันรันบนแล็ปท็อปเครื่องเดียวได้ เพียงแต่ยังช้าไปนิดสำหรับการใช้งานประจำวัน เพราะโมเดลแบบ dense (ไม่ใช่ MoE) ต้องการ memory bandwidth สูงมาก และเครื่องที่ผมมีก็ไม่ได้เด่นด้านนั้น
สิ่งที่สำคัญที่สุดของ Qwen 3.8 27B คือสิ่งที่มันพิสูจน์ให้เห็น เรามีโมเดลเปิดที่ความสามารถรอบด้าน ทั้ง context ยาว tool-calling ดี vision แข็ง และเขียนโค้ดเก่ง ใส่ในไฟล์ 17GB ได้ ไม่ต้องเสียเงินครึ่งล้านซื้อฮาร์ดแวร์ระดับดาตาเซ็นเตอร์เพื่อรันโมเดลที่ใช้งานได้จริงอีกต่อไป โมเดลไซส์นี้พัฒนาขึ้นเร็วจนน่ากลัว
Qwen 3.8 27B คือหลักฐานว่าโมเดลเปิดขนาดเล็กกำลังไล่บี้โมเดลปิดยักษ์ใหญ่ได้จริง แต่ถ้าอยากใช้ให้คุ้ม จำไว้อย่างนึง: ปิด "คิดมาก" ก่อน แล้วค่อยเปิดเมื่อจำเป็น ไม่ใช่ปล่อยให้มันคิดฟุ้งซ่าน 21 นาทีเพื่อวาดรูปนก
ที่มา: Simon Willison's Weblog — อ่านต้นฉบับ
ความคิดเห็น 3
กำลังโหลดความคิดเห็น...