เจาะประเด็น
AI Architectures
จัดการสมองกลให้ฉลาดเป็นระบบ ไม่ใช่ยัดข้อมูลขยะให้ AI มั่ว
ถอดรหัสเบื้องหลังสถาปัตยกรรม Agentic AI ทำไมการแยกแยะความจำกับความรู้ถึงเป็นเรื่องคอขาดบาดตาย
ทีมข่าว เอไอไทย.com
⏱ อ่าน 3 นาที
AI ที่ฉลาดจริงไม่ได้วัดกันที่ขนาดโมเดล แต่อยู่ที่ระบบจัดการข้อมูลก่อนส่งเข้าปากมัน
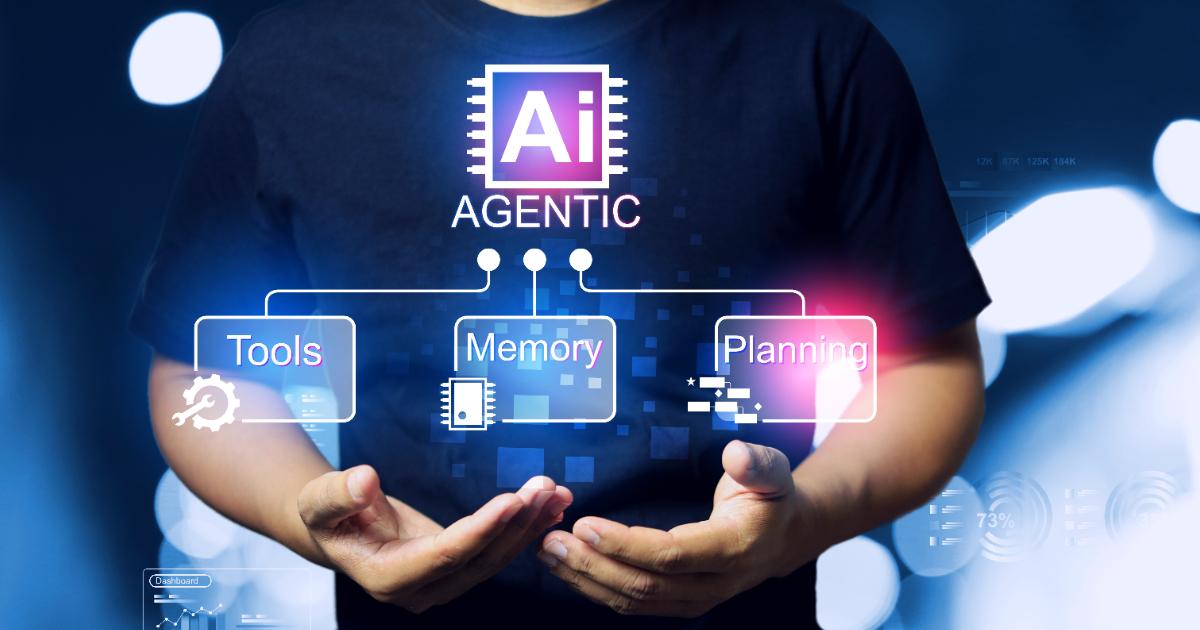
พอพูดถึง Agentic AI หลายคนพยายามวิ่งหาแต่โมเดลตัวใหญ่ๆ มาใช้ โดยลืมคิดไปว่าต่อให้โมเดลเก่งแค่ไหน ถ้าเราป้อนข้อมูลเข้าไปแบบสะเปะสะปะ ผลลัพธ์ที่ได้ก็ยังพังไม่เป็นท่าเหมือนเดิม เรื่องนี้ Adi Polak เขียนสรุปไว้ได้โคตรคมใน InfoQ ว่าด้วยเรื่องสถาปัตยกรรมระบบที่จัดการทั้งเรื่องความจำ ความรู้ และบริบทอย่างเป็นระบบ
ปัญหาหลักที่คนทำระบบ AI ชอบตกม้าตายกันบ่อยๆ คือการคิดว่าทุกอย่างมันคือข้อมูลก้อนเดียวกัน แล้วก็ยัดทุกอย่างลงไปในบริบททีเดียวจบ ซึ่งในความเป็นจริงแล้ว มันเหมือนการพยายามยัดความทรงจำทั้งหมดในชีวิตลงไปในสมองตอนที่กำลังจะตอบคำถามสัมภาษณ์งานนั่นแหละ มันเป็นไปไม่ได้และมีแต่จะทำให้ระบบเอ๋อรับประทาน
หัวใจสำคัญของการสร้างระบบ AI ที่พึ่งพาได้จริง เริ่มจากการแยกแยะองค์ประกอบสามอย่างออกจากกันให้เด็ดขาด ได้แก่ บริบท ความจำ และความรู้ สามสิ่งนี้มีหน้าที่และวงจรชีวิตที่ไม่เหมือนกันเลย การเอามากองรวมกันคือจุดเริ่มต้นของหายนะ
บริบท หรือ Context
ข้อมูลเฉพาะหน้าที่ถูกคัดเลือก บีบอัด และจัดการเรื่องวันหมดอายุ ก่อนจะถูกส่งเข้าไปให้โมเดลประมวลผลในแต่ละรอบ
ความจำ หรือ Memory
ข้อมูลที่ถูกจัดเก็บเป็นลำดับชั้น เพื่อให้เอเจนต์สามารถเรียกดูย้อนหลังและนำมาใช้ประกอบการตัดสินใจในระยะยาวได้
ความรู้ หรือ Knowledge
คลังข้อมูลที่ผ่านการคัดสรรและจัดเตรียมไว้เป็นอย่างดี เพื่อให้ระบบดึงข้อมูลที่ถูกต้องมาอ้างอิงได้ตลอดเวลา
พอเราแยกมันออกจากกันแล้ว หัวใจหลักจริงๆ มันจะไปอยู่ที่ Context Engine หรือเครื่องยนต์จัดการบริบท ตัวนี้แหละคือพระเอกตัวจริงที่จะทำหน้าที่คัดเลือก ฉีดข้อมูล บีบอัด และสั่งหมดอายุข้อมูลก่อนที่มันจะเดินทางไปถึงตัวโมเดลจริงๆ พูดง่ายๆ คือมันทำหน้าที่เป็นยามคอยคัดกรองว่าอะไรควรให้ AI รู้ตอนนี้ และอะไรควรเก็บไว้ก่อน
นอกจากเรื่องการจัดระเบียบแล้ว บทความนี้ยังเตือนถึง Anti-pattern หรือพฤติกรรมยอดฮิตที่ทำแล้วระบบพัง ซึ่งนักพัฒนาชอบทำกันโดยไม่รู้ตัว อย่างเช่น Context Stuffing หรืออาการกลัว AI ไม่รู้เรื่อง เลยยัดข้อมูลเข้าไปแบบไม่ลืมหูลืมตา กับ Stale Data Loops ที่ปล่อยให้ข้อมูลเก่าวนเวียนอยู่ในระบบจนทำให้ AI ตัดสินใจพลาดเรื่องเดิมซ้ำๆ
ทางแก้ที่ผู้เขียนแนะนำคือการทำ Token Budgeting หรือการจำกัดโควตาการใช้โทเค็นอย่างมีวินัย เหมือนเวลาเราจำกัดงบประมาณในกระเป๋า ไม่ใช่มีเท่าไหร่ก็ผลาญจนหมด ระบบ AI ก็ต้องการการบริหารจัดการทรัพยากรแบบนี้เหมือนกัน เพื่อให้มั่นใจว่าทุกโทเค็นที่เสียไปคุ้มค่าและตรงประเด็นที่สุด
เลิกฝากความหวังไว้ที่ความฉลาดของโมเดลอย่างเดียวได้แล้ว ยุคนี้ใครคุมสถาปัตยกรรมข้อมูลเบื้องหลังได้ดีกว่า คนนั้นแหละคือผู้ชนะตัวจริง
ที่มา: InfoQ AI/ML — อ่านต้นฉบับ
ความคิดเห็น 0
กำลังโหลดความคิดเห็น...