


















⚡ SPECIAL SCOOP ⚡
AI PREMIUM ANALYSIS
ถอดรหัสลายน้ำข้อความ AI: รอยสักล่องหนที่ฝังลึกในทุกตัวอักษร
📰 เกิดอะไรขึ้น
ในยุคที่โมเดลปัญญาประดิษฐ์สร้างบทความ งานวิจัย หรือแม้แต่นิยายได้แนบเนียนจนแยกด้วยตาเปล่าไม่ออก คำถามโลกแตกที่ตามมาเสมอคือ เราจะรู้ได้อย่างไรว่าข้อความท่อนนี้มนุษย์เขียนหรือ AI ปั่นขึ้นมา ล่าสุดบทความวิเคราะห์เชิงลึกจาก declaude.org ได้จุดประกายประเด็นร้อนบนเว็บบอร์ดสายเทคอย่าง Hacker News ด้วยการตีแผ่เบื้องลึกเบื้องหลังของเทคโนโลยี AI Text Watermarking หรือการฝังลายน้ำลงในข้อความ AI ว่าจริงๆ แล้วระบบนี้ทำงานอย่างไรกันแน่
หลายคนอาจจะจินตนาการไปถึงลายน้ำแบบรูปภาพที่มีโลโก้จางๆ หรือการซ่อนอักขระพิเศษล่องหนไว้ระหว่างช่องไฟ แต่ความจริงล้ำหน้ากว่านั้นเยอะมาก เพราะการฝังลายน้ำในข้อความระดับโมเดลภาษาขนาดใหญ่ (LLM) เป็นเรื่องของคณิตศาสตร์ สถิติ และความน่าจะเป็นล้วนๆ โดยเริ่มพัฒนาขึ้นมาเพื่อตอบโจทย์เรื่องความโปร่งใส ป้องกันข่าวปลอม และสกัดการทุจริตทางวิชาการ
เรื่องนี้กลายเป็นประเด็นที่คนในวงการนักพัฒนาและผู้ใช้ทั่วไปให้ความสนใจอย่างล้นหลาม เพราะบริษัทเทคโนโลยียักษ์ใหญ่หลายแห่งกำลังถูกกดดันจากหน่วยงานกำกับดูแลให้ต้องใส่กลไกยืนยันตัวตนลงในผลลัพธ์ของ AI การเปิดเผยหลักการทำงานอย่างละเอียดในครั้งนี้จึงทำให้ทุกคนได้เห็นว่า โค้ดลับที่ซ่อนอยู่หลังข้อความที่เราอ่านกันทุกวันนั้นมีหน้าตาและตรรกะแบบไหน
◆◆◆
🔍 เจาะลึกประเด็น
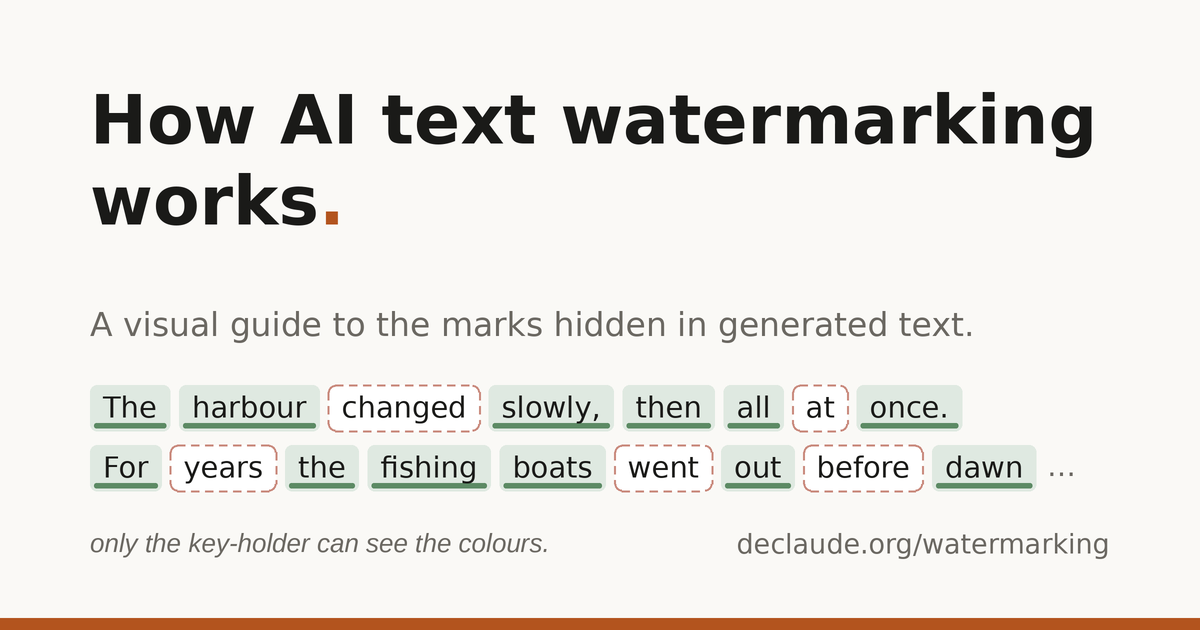
ถ้าจะอธิบายให้เห็นภาพง่ายๆ การทำงานของ LLM ในการสร้างข้อความแต่ละคำ มันจะประเมินความเป็นไปได้ของคำถัดไปออกมาเป็นรายการตัวเลือกพร้อมค่าน้ำหนักความน่าจะเป็น เทคโนโลยี Watermarking จะเข้ามาแทรกแซงตรงขั้นตอนนี้ โดยการใช้ฟังก์ชันสุ่มเทียมอิงจากคำก่อนหน้า มาแบ่งชุดคำศัพท์ออกเป็นสองฝั่ง คือ กลุ่มคำไฟเขียว (Green List) และกลุ่มคำไฟแดง (Red List)
ระบบจะแอบเพิ่มค่าน้ำหนักความน่าจะเป็นให้กับคำในกลุ่มไฟเขียวเล็กน้อย เพื่อบีบให้โมเดลมีแนวโน้มเลือกคำเหล่านั้นมาเรียงต่อกันเป็นประโยค มนุษย์ที่อ่านข้อความนี้จะไม่รู้สึกถึงความผิดปกติเลย เพราะคำที่เลือกมายังคงถูกหลักไวยากรณ์และความหมายครบถ้วน แต่ในเชิงสถิติ ข้อความที่มีลายน้ำจะมีอัตราส่วนของคำในกลุ่มไฟเขียวสูงผิดธรรมชาติอย่างมีนัยสำคัญ
ความสำคัญของกระบวนการนี้ส่งผลกระทบโดยตรงต่อระบบตรวจสอบความซื่อสัตย์ทางวิชาการและวงการสื่อ เพราะเครื่องมือตรวจจับที่มีกุญแจถอดรหัสจะสามารถสแกนข้อความยาวๆ แล้วคำนวณค่าทางสถิติเพื่อฟันธงได้ทันทีว่า ข้อความนี้กำเนิดมาจากโมเดลใด โดยไม่ต้องพึ่งพาโมเดลตรวจจับแบบเดาสุ่มที่มักจะชี้ผิดชี้ถูกเหมือนในอดีต
◆◆◆
💡 จุดที่น่าสนใจที่สุด
ความเจ๋งขั้นสุดของเทคนิคนี้คือ มันเป็นการสร้างลายน้ำแบบไม่ทำลายคุณภาพของภาษา (Quality-preserving) เพราะไม่ได้เป็นการบังคับเลือกคำแปลกๆ แต่เป็นการเลือกช้อยส์ที่เป็นธรรมชาติอยู่แล้ว แค่เอนเอียงไปทางคำไฟเขียว ทำให้ผู้ใช้ทั่วไปไม่มีทางสังเกตได้เลยว่าประโยคนั้นถูกประทับตรารหัสลับไว้เรียบร้อยแล้ว
แต่ดาบสองคมที่น่าคิดคือ ความเปราะบางต่อการดัดแปลง หากผู้ใช้นำข้อความนั้นไปเรียบเรียงใหม่ แปลเป็นภาษาอื่นแล้วแปลกลับ หรือสั่งให้โมเดลตัวอื่นสรุปความ โครงสร้างทางสถิติของคำไฟเขียวจะถูกทำลายและเจือจางลงทันที กลายเป็นเกมไล่จับที่ไม่มีวันจบสิ้นระหว่างผู้สร้างลายน้ำกับผู้พยายามลบลายน้ำ
◆◆◆
📌 มุมมองจากเอไอไทย
ในมุมมองของผม ลายน้ำข้อความไม่ใช่ทางออกเบ็ดเสร็จอย่างที่หลายฝ่ายพยายามผลักดัน แต่มันคือปราการด่านแรกที่ช่วยคัดกรองการใช้งานแบบมักง่ายได้ระดับหนึ่ง ใครที่คิดว่าการมีลายน้ำจะหยุดยั้งการสร้างข้อมูลเท็จหรือการลอกการบ้านได้ร้อยเปอร์เซ็นต์คงต้องคิดใหม่ เพราะตราบใดที่โมเดลแบบโอเพนซอร์สยังเปิดให้ทุกคนนำไปรันเองโดยปิดระบบลายน้ำได้ เทคโนโลยีนี้ก็จะมีผลบังคับใช้แค่กับผู้ให้บริการรายใหญ่เท่านั้น
สิ่งที่เราควรจับตาดูจริงๆ คือการกำหนดมาตรฐานสากล หากแต่ละค่ายอย่าง OpenAI, Anthropic หรือ Google ต่างคนต่างใช้สูตรคำนวณและกุญแจรหัสของตัวเอง โลกจะเต็มไปด้วยข้อความที่ไม่มีใครตรวจของใครได้ และภาระสุดท้ายจะตกอยู่ที่ผู้รับสารที่ต้องรับมือกับความสับสนนี้อยู่ดี
🔮 สรุปแบบเทพ
ลายน้ำข้อความ AI คือการร่ายมนตร์ทางสถิติที่ฝังดีเอ็นเอของโมเดลลงในคำศัพท์อย่างแยบยล เป็นนวัตกรรมที่ชาญฉลาดแต่ยังห่างไกลจากคำว่าสมบูรณ์แบบ ทิศทางต่อไปคือสงครามระหว่างอัลกอริทึมฝังรหัสกับเครื่องมือลบรอยสัก ที่จะผลักดันให้วงการตรวจจับคอนเทนต์ต้องก้าวข้ามจากการตรวจแค่โครงสร้างคำ ไปสู่การตรวจสอบเจตนาและบริบทของข้อมูลอย่างแท้จริง
ที่มา: Hacker News (AI) — อ่านต้นฉบับ
ความคิดเห็น 5
กำลังโหลดความคิดเห็น...